توهان کي شايد هي تجربو ٿيو هوندو: هڪ وائيس اسسٽنٽ توهان جي دوست کي چڱي طرح سمجهي ٿو، پر توهان جي لهجي سان، يا توهان جي والدين جي ڳالهائڻ جي انداز سان جدوجهد ڪري ٿو.
ساڳي ٻولي. ساڳي درخواست. تمام مختلف نتيجا.
اهو خال بلڪل اهو آهي جتي سماجي صوتيات رهن ٿا - ۽ ڇو اهو اوچتو AI لاءِ تمام گهڻو اهم آهي.
سماجي صوتيات اهو ڏسي ٿو ته سماجي عنصر ۽ تقرير جا آواز ڪيئن لهه وچڙ ڪن ٿا . جڏهن توهان ان کي تقرير ٽيڪنالاجي سان ڳنڍيندا آهيو، ته اهو منصفانه، وڌيڪ قابل اعتماد ASR، TTS، ۽ آواز اسسٽنٽ ٺاهڻ لاءِ هڪ طاقتور لينس بڻجي ويندو آهي.
هن آرٽيڪل ۾، اسين سماجي صوتيات کي سادي ٻولي ۾ بيان ڪنداسين، پوءِ ڏيکارينداسين ته اهو ڪيئن توهان جي تقرير ڊيٽا کي ڊزائين ڪرڻ، ماڊلز کي تربيت ڏيڻ، ۽ ڪارڪردگي جو جائزو وٺڻ جي طريقي کي تبديل ڪري سگهي ٿو.
1. لسانيات کان مصنوعي ذهانت تائين: سماجي صوتيات اوچتو ڇو لاڳاپيل آهي
ڏهاڪن تائين، سماجي صوتيات گهڻو ڪري هڪ علمي موضوع هو. محقق ان کي سوالن جي مطالعي لاءِ استعمال ڪندا هئا جهڙوڪ:
- مختلف سماجي گروهه "ساڳي" آوازن جو تلفظ ڪيئن ڪندا آهن؟
- ٻڌندڙ تلفظ ۾ ننڍڙن فرقن مان سماجي اشارا - عمر، علائقو، سڃاڻپ - ڪيئن سمجهندا آهن؟
هاڻي، AI انهن سوالن کي پراڊڪٽ ميٽنگن ۾ آندو آهي.
جديد تقريري نظام ملڪن، لهجن ۽ سماجي پس منظرن ۾ لکين استعمال ڪندڙن لاءِ استعمال ڪيا ويا آهن. هر ڀيري جڏهن ڪو ماڊل ڪنهن خاص تلفظ، عمر جي گروپ، يا برادري سان جدوجهد ڪري ٿو، ته اهو صرف هڪ بگ ناهي - اهو ماڻهن جي ڳالهائڻ جي طريقي ۽ ماڊل انهن جي توقع جي وچ ۾ هڪ سماجي-صوتي بي ترتيبي آهي.
انهي ڪري ٽيمون ڪم ڪري رهيون آهن ASR، TTS، ۽ وائيس UX پڇڻ شروع ڪن ٿا:
"اسان ڪيئن پڪ ڪريون ٿا ته اسان جي تربيت ۽ تشخيص واقعي ان جي عڪاسي ڪن ٿا جنهن جي اسان خدمت ڪرڻ چاهيون ٿا؟"
2. سماجي صوتيات ڇا آهي؟ (سادي ٻولي جي تعريف)
رسمي طور تي، سماجي صوتيات لسانيات جي شاخ آهي جيڪا سماجي لسانيات (سماجي گروهن ۾ ٻولي ڪيئن مختلف ٿئي ٿي) ۽ صوتيات (تقرير جي آوازن جو مطالعو) کي گڏ ڪري ٿي.
عملي طور تي، اهو سوال پڇي ٿو جهڙوڪ:
- عمر، جنس، علائقو، نسل، ۽ سماجي طبقو تلفظ تي ڪيئن اثر انداز ٿين ٿا؟
- ٻڌندڙ ڪيئن نفيس آواز جي فرق کي استعمال ڪندي سڃاڻن ٿا ته ڪو ماڻهو ڪٿان جو آهي، يا اهي پاڻ کي ڪيئن ڏسن ٿا؟
- برادرين ۽ سڃاڻپن جي تبديليءَ سان وقت سان گڏ اهي نمونا ڪيئن بدلجن ٿا؟
توهان ان کي هن طرح سوچي سگهو ٿا: جيڪڏهن صوتياتيات اهو ڪئميرا آهي جيڪو تقرير جي آوازن کي پڪڙي ٿو، ته پوءِ سماجي صوتياتيات اهو دستاويزي دستاويز آهي جيڪو ڏيکاري ٿو ته حقيقي ماڻهو انهن آوازن کي سڃاڻپ، تعلق ۽ جذبات جي نشاندهي لاءِ ڪيئن استعمال ڪندا آهن.
ڪجھ ٺوس مثال:
- انگريزي ۾، ڪجهه ڳالهائيندڙ "thing" کي مضبوط "g" سان تلفظ ڪندا آهن، ٻيا نه - ۽ اهي چونڊون علائقي يا سماجي گروهه کي اشارو ڪري سگهن ٿيون.
- ڪيترين ئي ٻولين ۾، لهجي ۽ تال جا نمونا علائقي يا برادري جي لحاظ کان مختلف هوندا آهن، جيتوڻيڪ لفظ "ساڳيا" هوندا آهن.
- نوجوان ڳالهائيندڙ شايد خاص ثقافتي سڃاڻپ سان مطابقت پيدا ڪرڻ لاءِ نوان تلفظ اختيار ڪن.
سماجي صوتيات انهن نمونن جو تفصيل سان مطالعو ڪري ٿو - اڪثر ڪري صوتي ماپن، تصور جي ٽيسٽن، ۽ وڏي ڪارپورا سان - اهو سمجهڻ لاءِ ته سماجي معنيٰ آواز ۾ ڪيئن انڪوڊ ٿيل آهي.
هڪ رسائي لائق تعارف لاءِ، sociophonetics.com تي وضاحت ڏسو.
3. سماجي صوتيات تقرير جي تبديلي جو مطالعو ڪيئن ڪري ٿو
سماجي صوتي تحقيق عام طور تي ٻن وسيع علائقن تي نظر رکي ٿي:
- پيداوار - ماڻهو اصل ۾ آواز ڪيئن پيدا ڪندا آهن.
- چين - ٻڌندڙ انهن آوازن ۽ انهن جي سماجي اشارن جي ڪيئن تشريح ڪن ٿا.
ڪجھ اهم اجزا:
- ڀاڱيدار خاصيتون: سُر ۽ وينجن (مثال طور، ڪيئن /r/ يا ڪجهه سُر علائقي جي لحاظ کان مختلف آهن).
- مٿيون حصو (پروسوڊي): تال، دٻاءُ، ۽ آواز جا نمونا.
- آواز جي معيار: ساهه کڻڻ، چرڪڻ، ۽ ٻيون خوبيون جيڪي سماجي معنيٰ کڻي سگهن ٿيون.
طريقياتي طور تي، سماجي فونيٽڪ ڪم استعمال ڪري ٿو:
- صوتي تجزيو (فارمينٽس، پچ، ٽائيمنگ کي ماپڻ).
- تصور جا تجربا (ٻڌندڙ تقرير جي نمونن کي ڪيئن درجه بندي ڪن ٿا يا فيصلو ڪن ٿا).
- سماجي لساني انٽرويو ۽ ڪارپورا (حقيقي گفتگو جا وڏا ڊيٽاسيٽ، سماجي عنصرن لاءِ تشريح ڪيل).
وڏو فائدو اهو آهي ته تبديلي "شور" ناهي - اها منظم، بامعني، ۽ سماجي طور تي نموني سان ٺهيل آهي.
اهو ئي سبب آهي جو AI ان کي نظرانداز نٿو ڪري سگهي.
4. جتي سماجي صوتيات AI ۽ تقرير ٽيڪنالاجي سان ملن ٿا
تقرير ٽيڪنالاجيون - ASR، TTS، وائس بوٽس - تقرير جي ڊيٽا جي مٿان ٺهيل آهن . جيڪڏهن اهو ڊيٽا سماجي فونيٽڪ تبديلي کي پڪڙي نه ٿو سگهي، ته ماڊل ناگزير طور تي ڪجهه گروپن لاءِ وڌيڪ ناڪام ٿيندا.
تيز ٿيل ASR تي تحقيق ڏيکاري ٿي ته:
- ڪجهه تلفظن ۽ لهجن لاءِ لفظن جي غلطي جي شرح ڊرامائي طور تي وڌيڪ ٿي سگهي ٿي.
- محدود تربيتي ڊيٽا سان گڏ تلفظ واري تقرير خاص طور تي مشڪل آهي.
- ٻولين ۾ عام ڪرڻ لاءِ امير، متنوع ڊيٽاسيٽ ۽ محتاط تشخيص جي ضرورت آهي.
سماجي فونيٽڪ لينس کان، عام ناڪامي جا طريقا شامل آهن:
- تلفظ جو تعصب: هي نظام "معياري" يا چڱي طرح نمائندگي ڪيل تلفظن لاءِ بهترين ڪم ڪري ٿو.
- مقامي شڪلن جي گهٽ سڃاڻپ: علائقائي تلفظ، سُرن جي تبديلي، ۽ عروضي نمونن کي غلط سمجهيو ويندو آهي.
- غير مساوي UX: ڪجهه استعمال ڪندڙن جو خيال آهي ته سسٽم "مون جهڙن ماڻهن لاءِ نه ٺاهيو ويو هو."
سماجي صوتيات توهان کي انهن مسئلن کي نالو ڏيڻ ۽ ماپڻ ۾ مدد ڪري ٿي. اهو AI ٽيمن کي انهن جي ڊيٽا ۽ ميٽرڪس ۾ ڇا غائب آهي ان لاءِ هڪ لفظي لفظ ڏئي ٿو.
5. سماجي فونيٽڪ لينس سان تقرير ڊيٽا ڊيزائن ڪرڻ
گهڻيون تنظيمون اڳ ۾ ئي ٻولي جي ڪوريج بابت سوچينديون آهن ("اسان انگريزي، اسپيني، هندي جي حمايت ڪريون ٿا..."). سماجي صوتيات توهان کي وڌيڪ گہرائي ۾ وڃڻ لاءِ مجبور ڪري ٿي:
5.1 پنهنجي سماجي فونيٽڪ "ڪائنات" جو نقشو ٺاهيو
لسٽنگ سان شروع ڪريو:
- ٽارگيٽ مارڪيٽون ۽ علائقا (مثال طور، آمريڪا، برطانيه، هندستان، نائيجيريا).
- چاٻي هر ٻوليءَ ۾ مختلف قسمون (علائقائي لهجا، نسلي لهجا، سماجي لهجا).
- استعمال ڪندڙ حصا جيڪي اهم آهن: عمر جي حد، صنفي تنوع، ڳوٺاڻي/شهري، پيشه ورانه ڊومين.
هي توهان جي سماجي صوتي ڪائنات آهي - آوازن جي جاءِ جيڪا توهان چاهيو ٿا ته توهان جو نظام خدمت ڪري.
5.2 اهڙي تقرير گڏ ڪريو جيڪا ان ڪائنات کي ظاهر ڪري ٿي.
هڪ دفعو توهان کي پنهنجي ٽارگيٽ اسپيس جي خبر پئجي ويندي، ته پوءِ توهان ان جي چوڌاري ڊيٽا گڏ ڪرڻ جو ڪم ٺاهي سگهو ٿا:
- سڄي دنيا ۾ ڳالهائيندڙن کي ڀرتي ڪريو علائقا، عمر جا گروپ، جنس، ۽ برادريون.
- گھڻن چينلن کي ڪيپچر ڪريو (موبائل، پري فيلڊ مائڪروفون، ٽيليفوني).
- ئي شامل ڪريو پڙهڻ تقرير ۽ قدرتي رفتار، تال ۽ انداز ۾ حقيقي دنيا جي تبديلين کي سامهون آڻڻ لاءِ گفتگو.
شيپ جي تقرير ۽ آڊيو ڊيٽاسيٽس ۽ تقرير ڊيٽا گڏ ڪرڻ جون خدمتون بلڪل اهو ڪرڻ لاءِ ٺهيل آهن - 150+ ٻولين ۾ لهجن، سرن ۽ تلفظن کي نشانو بڻائڻ.
5.3 صرف لفظن تي نه، پر سماجي فونيٽڪ ميٽا ڊيٽا کي تشريح ڪريو
هڪ ٽرانسڪرپٽ پاڻ ۾ توهان کي اهو نٿو ٻڌائي ته ڪير ڳالهائي رهيو آهي يا انهن جو آواز ڪيئن آهي.
پنهنجي ڊيٽا کي سماجي فونيٽڪس کان آگاهه ڪرڻ لاءِ، توهان شامل ڪري سگهو ٿا:
- اسپيڪر-سطح ميٽا ڊيٽا: علائقو، پاڻ بيان ڪيل لهجو، غالب ٻولي، عمر جي حد.
- تقرير جي سطح جا ليبل: تقرير جو انداز (آرامده بمقابله رسمي)، چينل، پس منظر جو شور.
- خاص ڪمن لاءِ، تنگ پيهونيٽڪ ليبل يا پروسوڊڪ تشريحون.
هي ميٽا ڊيٽا توهان کي بعد ۾ سماجي ۽ صوتياتي سلائسن جي ڪارڪردگي جو تجزيو ڪرڻ جي اجازت ڏئي ٿو ، نه رڳو مجموعي طور تي.
6. سماجي صوتيات ۽ ماڊل تشخيص: هڪ واحد WER کان ٻاهر
گهڻيون ٽيمون هر ٻولي لاءِ هڪ واحد WER (لفظ جي غلطي جي شرح) يا MOS (مطلب راءِ جو اسڪور) رپورٽ ڪن ٿيون. سماجي صوتيات توهان کي ٻڌائي ٿي ته اهو ڪافي ناهي.
توهان کي پڇڻ گهرجي:
- WER ڪيئن مختلف ٿئي ٿو؟ تلفظ جي لحاظ کان?
- ڇا ڪجهه عمر جا گروپ يا علائقا مسلسل بدتر حالت ۾ آهن؟
- ڇا TTS ڪجهه آوازن لاءِ ٻين جي ڀيٽ ۾ "وڌيڪ قدرتي" لڳندو آهي؟
هڪ تيز ڪيل ASR سروي اهو نمايان ڪري ٿو ته ڪيتري مختلف ڪارڪردگي ٻولين ۽ تلفظن ۾ ٿي سگهي ٿي - جيتوڻيڪ هڪ ٻولي اندر.
هڪ سادي پر طاقتور تبديلي هي آهي:
- تعمير ڪريو ٽيسٽ سيٽ، تلفظ، علائقي، ۽ اهم آبادي جي لحاظ کان سطحي ٿيل آهن.
- ميٽرڪس جي رپورٽ ڪريو هر تلفظ ۽ هر سماجي فونيٽڪ گروپ لاءِ.
- وڏين تفاوتن کي صرف ٽيڪنيڪل تجسس نه پر پهرين درجي جي پراڊڪٽ جي خرابين طور سمجهو.
اوچتو، سماجي صوتيات صرف نظريو ناهي - اهو توهان جي ڊيش بورڊ ۾ آهي.
تقرير جي سڃاڻپ جي ڊيٽا جي منصوبابندي ۽ تشخيص ۾ وڌيڪ تفصيل لاءِ، شيپ جي تقرير جي سڃاڻپ لاءِ تربيتي ڊيٽا تي گائيڊ ڊيٽا سيٽ ۽ تشخيص جي تقسيم کي ڪيئن ڊيزائن ڪجي جيڪي حقيقي استعمال ڪندڙن کي ظاهر ڪن ٿا ان بابت ڳالهائي ٿو.
7. ڪيس اسٽڊي: بهتر ڊيٽا سان ايڪسينٽ تعصب کي درست ڪرڻ
هڪ فن ٽيڪ ڪمپني انگريزي ٻولي جو وائيس اسسٽنٽ لانچ ڪري ٿي. استعمال ڪندڙ جي ٽيسٽن ۾، سڀ ڪجهه ٺيڪ نظر اچي ٿو. لانچ کان پوءِ، سپورٽ ٽڪيٽون هڪ علائقي ۾ وڌيون آهن. جڏهن ٽيم اندر وڃي ٿي، ته انهن کي ملي ٿو:
- هڪ خاص علائقائي تلفظ وارن استعمال ڪندڙن کي غلطي جي شرح تمام گهڻي نظر اچي رهي آهي.
- ASR پنهنجي سُر نظام ۽ تال سان جدوجهد ڪري ٿو، جنهن جي ڪري غلط سڃاڻپ ٿيل اڪائونٽ نمبر ۽ حڪم مليا آهن.
- تربيتي سيٽ ۾ ان علائقي جا تمام گهٽ ڳالهائيندڙ شامل آهن.
سماجي صوتي نقطه نظر کان، هي بلڪل به حيران ڪندڙ نه آهي: ماڊل کي ڪڏهن به اهو تلفظ سکڻ لاءِ نه چيو ويو هو.
هتي ٽيم ان کي ڪيئن درست ڪري ٿي:
نتيجو: ان علائقي لاءِ غلطين ۾ ماپي سگهجي ٿو گهٽتائي، بهتر استعمال ڪندڙ جي اطمينان جا اسڪور، ۽ هڪ واضح اندروني سمجھ ته سماجي فونيٽڪ ڪوريج هڪ پيداوار جي گهرج آهي ، نه ته سٺي شيءِ.
8. شيپ سماجي صوتيات کي ڪيئن هلائڻ ۾ مدد ڪري ٿو
سماجي صوتي بصيرت کي پيداواري نظام ۾ تبديل ڪرڻ لاءِ ٽن شين جي ضرورت آهي:
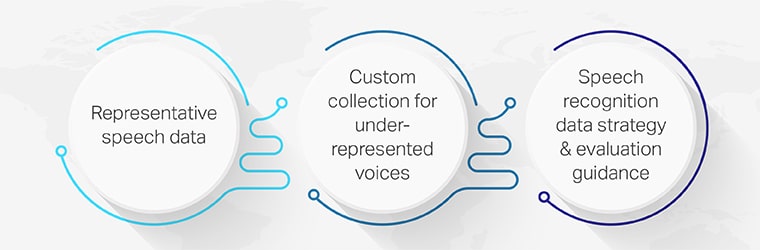
- نمائندگي واري تقرير ڊيٽا: شيپ وڏي پيماني تي پيش ڪري ٿو تقرير ۽ آڊيو ڊيٽاسيٽ جنهن ۾ اڳ ۾ ئي ٻولين، لهجن، ۽ رڪارڊنگ جي حالتن جو ميلاپ شامل آهي - سماجي صوتي وسعت لاءِ هڪ مضبوط شروعاتي نقطو.
- گهٽ نمائندگي ڪندڙ آوازن لاءِ ڪسٽم ڪليڪشن: لہجن، سماجيات، يا آف دي شيلف ڊيٽا مان غائب برادرين لاءِ، شيپ جو تقرير ڊيٽا گڏ ڪرڻ جون خدمتون صحيح اسپيڪر، چينل، ۽ منظرنامو ڀرتي ۽ رڪارڊ ڪري سگھن ٿا - ان پيماني تي جيڪو توهان جي ماڊلز کي گهرجي.
- تقرير جي سڃاڻپ ڊيٽا حڪمت عملي ۽ تشخيص جي رهنمائي: شيپ وانگر رهنما تقرير جي سڃاڻپ ڊيٽاسيٽ جي چونڊ ۽ ٽريننگ-ڊيٽا پلي بڪ ٽيمن کي ڊيٽاسيٽس ۽ ٽيسٽ سيٽن جي منصوبابندي ڪرڻ ۾ مدد ڪن ٿا جيڪي حقيقي سماجي فونيٽڪ تبديلي سان مطابقت رکن ٿا، نه رڳو ٻولي جي ليبلن سان.
جڏهن توهان سماجي صوتيات کي هن قسم جي ڊيٽا ۽ تشخيص جي بنيادي ڍانچي سان گڏ ڪندا آهيو ، ته توهان هتي کان منتقل ٿيندا آهيو:
"اسين انگريزي جي حمايت ڪريون ٿا." ڏانهن:
"اسين انگريزي کي سپورٽ ڪريون ٿا جيئن اصل ۾ اسان جي استعمال ڪندڙن پاران ڳالهايو ويندو آهي - علائقن، تلفظن ۽ برادرين ۾ - ۽ اسان ان کي پنهنجي ميٽرڪس ۾ ثابت ڪري سگهون ٿا."