چيٽ بوٽس کان روبوٽس ڏانهن منتقلي جيڪي قدرتي ٻولي جي حڪمن تي عمل ڪن ٿا، ماڊلز جي هڪ ئي طبقي ذريعي هلندي آهي. VLA ماڊل - وژن-ٻولي-عمل ماڊل - هڪ نيورل نيٽ ورڪ ۾ بصري تصور، ٻولي جي سمجھ، ۽ عمل جي پيداوار کي گڏ ڪن ٿا. انهن جي طاقت حقيقي آهي، پر اهو تقريبن مڪمل طور تي تربيتي ڊيٽا تي منحصر آهي جيڪو اهي نگلندا آهن. هي گائيڊ وضاحت ڪري ٿو ته VLA ٽريننگ ڊيٽا اصل ۾ ڇا شامل آهي، ڪهڙيون ٽيمون گهٽ سمجهن ٿيون، ۽ هڪ ڊيٽاسيٽ کي ڪيئن پلان ڪجي جيڪو هڪ ماڊل پيدا ڪري ٿو جيڪو تعینات ڪرڻ جي لائق آهي. انهي ڊيٽاسيٽ کي ٺاهڻ بلڪل اهو آهي جيڪو شيپ جي جسماني AI تربيتي ڊيٽا پروگرام پهچائي ٿو - هم وقت ساز وژن، ٻولي، ۽ عمل ڊيٽا حقيقي دنيا جي روبوٽڪس لاءِ قبضو ڪيو ويو.
ڪيٻئي جا رستا
- وي ايل اي ماڊل هڪ نيٽ ورڪ ۾ روبوٽ جي عملن سان سڌو سنئون ويزن ۽ ٻولي ان پٽ جو نقشو ٺاهيندا آهن.
- تربيتي ڊيٽا ۾ هم وقت ساز بصري مشاهدا، ٻولي جون هدايتون، ۽ عمل شامل هجڻ گهرجن.
- ڊسڪريٽ ايڪشن ٽوڪن کي چڱي طرح سکڻ لاءِ وڏي پيماني تي مظاهري ڊيٽا جي ضرورت آهي.
- خود غرض انساني وڊيو کي گهٽ قيمت واري VLA پري ٽريننگ ذريعو جي طور تي تيزي سان ڪڍيو پيو وڃي.
- مضبوط تشخيصي قسطون قابل اعتماد تعیناتي لاءِ تربيتي ڊيٽا جيتريون اهم آهن.
- وي ايل اي فائن ٽيوننگ صرف خام حجم تي نه پر تشريح جي سختي تي ڪامياب ٿئي ٿي يا ناڪام ٿئي ٿي.
وي ايل اي ماڊل ڇا آهي؟
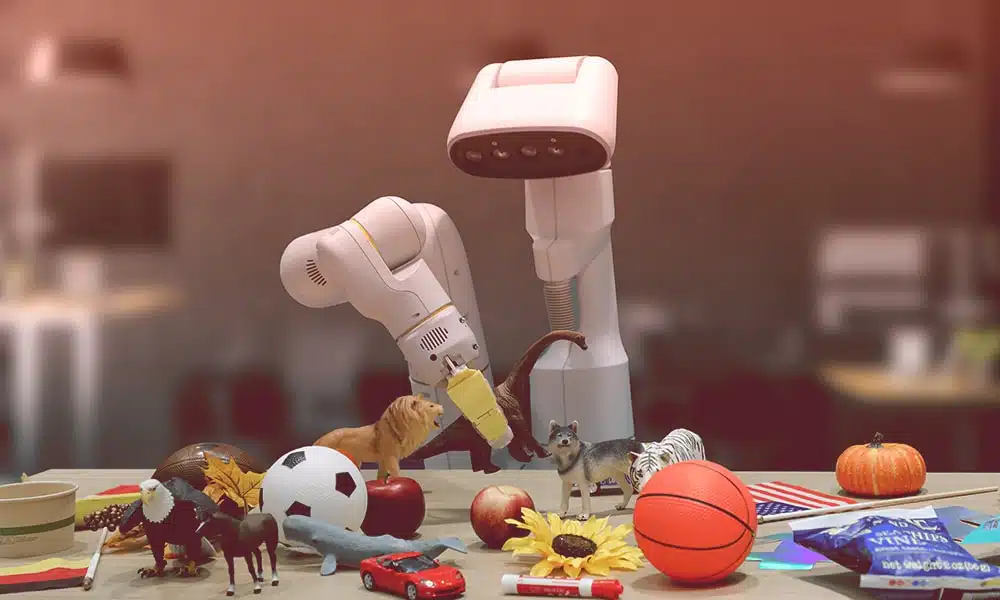
هڪ وي ايل اي ماڊل هڪ روبوٽڪ فائونڊيشن ماڊل آهي جيڪو تصويرون ۽ قدرتي ٻولي جي هدايتن کي ان پٽ طور وٺندو آهي ۽ روبوٽ جي عملن کي آئوٽ پُٽ ڪندو آهي. روايتي پائپ لائنن جي برعڪس جيڪي تصور، منصوبابندي، ۽ ڪنٽرول کي مختلف ماڊلز ۾ الڳ ڪندا آهن، ويزن-ٻولي-عمل ماڊل هڪ ئي نيٽ ورڪ ۾ اينڊ-ٽو-اينڊ ميپنگ سکندا آهن.

وي ايل اي ماڊل: هڪ نيورل نيٽ ورڪ جيڪو هم وقت سازي سان بصري مشاهدا ۽ قدرتي ٻولي جون هدايتون وٺندو آهي ۽ روبوٽ جي عملن يا عمل جي ٽوڪن جي ترتيب پيدا ڪندو آهي.
هي متحد ڊيزائن VLA ماڊلز کي وڏي بصري ٻولي جي اڳڀرائي کان استدلال جي صلاحيتن کي ورثي ۾ ڏيڻ ۽ انهن کي موٽر ڪنٽرول سان وڌائڻ جي اجازت ڏئي ٿو. تعیناتي لاءِ، ان جو مطلب آهي ته هڪ ماڊل اصولي طور تي ڪيترن ئي ڪمن کي انجام ڏئي سگهي ٿو - پر صرف ان صورت ۾ جڏهن ان جو تربيتي ڊيٽا انهن کي صحيح structure سان ڍڪيندو آهي.
VLA ٽريننگ ڊيٽا اصل ۾ ڇا تي مشتمل آهي؟
وي ايل اي ٽريننگ ڊيٽا ۾ هر قسط ۾ چار بنيادي اجزا شامل آهن: بصري مشاهدو، هڪ قدرتي ٻولي جي هدايت، هڪ عمل جي رفتار، ۽ ڪاميابي يا ناڪامي جو ليبل. انهن جي چوڌاري، ٽيمون ٽائيم اسٽيمپ، پروپرائيوسيپٽو اسٽيٽ، ۽ تشخيصي نشان شامل ڪن ٿيون.

چار لازمي پرتون:
- بصري مشاهدا - آر جي بي فريم، اڪثر ڪري ڊيپٿ يا ڪلائي-ڪيم جي نظارن سان جوڙيل هوندا آهن.
- ٻولي جون هدايتون - مختصر قدرتي ٻولي جا حڪم جيئن ته "پيالي ۾ پاڻي وجھو."
- عمل جا طريقا — روبوٽ جي آزادي جي درجي سان نقش ٿيل الڳ ٿيل يا مسلسل عمل جا تسلسل.
- نتيجو ليبل - هر قسط ۾ واضح ڪاميابي، ناڪامي، يا جزوي مڪمل ٿيڻ جا نشان.
7-ارب-پيراميٽر اوپن وي ايل اي ماڊل کي 22 روبوٽ جي مجسمن مان ورتل هڪ ملين کان وڌيڪ قسطن تي تربيت ڏني وئي (اسٽينفورڊ ۽ ٻيا، 2024)، جيڪو ڪراس-ٽاسڪ جنرلائيزيشن لاءِ متوقع تنوع کي واضح ڪري ٿو. هن وسعت کان سواءِ، وي ايل اي ماڊل عام ڪرڻ جي بدران مخصوص شين کي ياد ڪرڻ جو رجحان رکن ٿا.
عمل جي تشريح تصوير جي تشريح کان وڌيڪ ڏکيو ڇو آهي؟
عمل جي تشريح وڌيڪ ڏکيو آهي ڇاڪاڻ ته عمل مسلسل، اعليٰ طول و عرض واري جڳهن ۾ رهن ٿا ۽ صرف فريم مواد تي نه پر روبوٽ جي مجسمي تي منحصر آهن. هڪ ڪپ تي باؤنڊنگ باڪس کي ليبل ڪرڻ سڌو آهي؛ هڪ ٽريجڪٽري کي ليبل ڪرڻ جيڪو ڪاميابي سان ان ڪپ کي هڪ مخصوص گريپر سان هڪ مخصوص رابطي واري نقطي تي پڪڙي ٿو، اهو ڏکيو ناهي.
عمل جو نشان: روبوٽ جي حرڪت يا آخري اثر واري بي گھرڻ جي هڪ الڳ نمائندگي جيڪا هڪ VLA ماڊل ٻولي جي نشان وانگر اڳڪٿي ڪري سگهي ٿي.
تشريح ٽيمن کي هر عمل جي ٽوڪن کي ان جي هم وقت ساز مشاهدي سان ترتيب ڏيڻ، رابطي جي فوري طور تي نشان لڳائڻ، ناڪامي جي بحالي کي پڪڙڻ، ۽ ٻولي جي هدايتن جي ايٽمي حدن کي ٽيگ ڪرڻ جي ضرورت آهي. شيپ جي ڊيٽا تشريح ورڪ فلو هن کي پيماني تي سنڀاليندا آهن، منظم ٽيڪسونوميز کي روبوٽڪ ايڪشن اسپيس ۽ في-ٽاسڪ قبوليت جي حدن سان ترتيب ڏنل آهي.
وي ايل اي ٽريننگ ۾ خود غرض انساني وڊيو ڪٿي فٽ ٿئي ٿي؟

هڪ تازي پيپر غير منظم خود غرض انساني وڊيوز کي VLA-فارميٽ ٿيل قسطن ۾ تبديل ڪيو - 1 ملين حصا ۽ 26 ملين فريم - انساني هٿ کي هڪ ماهر اينڊ-اثر ڪندڙ جي طور تي علاج ڪندي (وو ۽ ٻيا، arXiv، 2025). هن قسم جي ڪراس-ايمبڊمينٽ ڊيٽا هاڻي VLA پري ٽريننگ ترڪيبون ۾ معمول آهي.
مسئلو: خام وڊيو تربيتي ڊيٽا نه آهي. ان کي VLA پائپ لائن تائين پهچڻ کان اڳ سيگمينٽيشن، ٻولي جي وضاحت، هٿ جي پوز ريٽارگيٽنگ، ۽ معيار جي تصديق جي ضرورت آهي. شيپ جي فزيڪل AI ڊيٽا آپريشنز ۾ ايگو سينٽرڪ ڪيپچر، ريئل 2 سم ڪنورشن، ۽ هڪ ئي ترسيل ۾ VLA-الائنڊ اينوٽيشن شامل آهن.
[پڻ پڙهو: اسان جي خود غرض وڊيو ڊيٽا گڏ ڪرڻ جي خدمتن کي ڳوليو ]
توهان تشخيصي سيٽ ڪيئن ٺاهيندا آهيو جيڪي VLA ناڪامي طريقن کي پڪڙيندا آهن؟
تشخيصي سيٽ VLA ناڪامي جي طريقن کي پڪڙيندا آهن جڏهن اهي تربيت کان اڳ ٺهيل هوندا آهن، نه ته بعد ۾. ٽي جوڙجڪ سڀ کان وڌيڪ اهم آهن: تقسيم ۾ ڪاميابي جا معيار، تقسيم کان ٻاهر جنرلائيزيشن پروبس، ۽ خطري جي سطح تي حفاظتي منظرنامو.
تصور ڪريو هڪ گهريلو VLA ماڊل جيڪو باورچی خانه جي ڪمن تي وڏي پيماني تي تربيت يافته هجي. هڪ معقول تشخيصي سيٽ جانچ ڪندو: ڄاتل سڃاتل باورچی خانه ۾ ڄاتل سڃاتل ڪم (ورهائڻ ۾)، اڻڄاتل روشني ۾ ڄاتل سڃاتل ڪم (هلڪي OOD)، ڄاتل سڃاتل هدايتن سان اڻڄاتل شيون (تصور جي عام ڪرڻ)، ۽ ناياب واقعا جهڙوڪ حادثاتي اسپل (حفاظتي سطح). هر هڪ کان سواءِ، تعیناتي جو خطرو غير ماپيل رهي ٿو.
خطري جي سطح جي ڪوريج کي منظم ڪرڻ لاءِ هڪ مفيد غير جانبدار وسيلو NIST AI خطري جي انتظام جو فريم ورڪ آهي ، جيڪو اثر جي سطحن کي اهڙي طرح الڳ ڪري ٿو جيڪو تشخيصي سيٽ ڊيزائن تي صاف طور تي نقشو ٺاهي ٿو.