منظم ڪيل ڊيٽا جو تجزيو بهتر تشخيص ۽ مريض جي سنڀال ۾ مدد ڪري سگھي ٿو. بهرحال، غير منظم ٿيل ڊيٽا جو تجزيو انقلابي طبي ڪاميابين ۽ دريافتن کي وڌائي سگھي ٿو.
هي آهي مضمون جو خلاصو جنهن تي اسين اڄ بحث ڪنداسين. اهو مشاهدو ڪرڻ تمام دلچسپ آهي ته صحت جي سار سنڀار ٽيڪنالاجي جي خلا ۾ ڪيتريون ئي بنيادي ترقيون صرف 10-20٪ استعمال جي قابل صحت جي ڊيٽا سان ٿي چڪا آهن.
انگ اکر ظاهر ڪن ٿا ته هن اسپيڪٽرم ۾ 90 سيڪڙو کان وڌيڪ ڊيٽا غير منظم آهي، جيڪا ڊيٽا کي ترجمو ڪري ٿي جيڪا گهٽ استعمال لائق آهي ۽ سمجهڻ، تفسير ۽ لاڳو ڪرڻ وڌيڪ ڏکيو آهي. اينالاگ ڊيٽا کان وٺي ڊاڪٽر جي نسخي تائين ڊجيٽل ڊيٽا جي شڪل ۾ ميڊيڪل اميجنگ ۽ آڊيو ويزوئل ڊيٽا، غير منظم ڊيٽا مختلف قسمن جا آهن.
غير منظم ٿيل ڊيٽا جا اهڙا وڏا حصا ناقابل اعتماد بصيرت جو گهر آهن جيڪي ڏهاڪن تائين صحت جي سار سنڀار جي ترقي کي تيز ڪري سگهن ٿيون. اهو ٿي سگهي ٿو دوا جي دريافت نازڪ زندگي استعمال ڪندڙ خودڪار مدافعتي بيمارين لاءِ ڊيٽا جي لاءِ جيڪا صحت جي سار سنڀار انشورنس ڪمپنين کي خطري جي تشخيص ۾ مدد ڪري سگهي ٿي، غير منظم ڊيٽا اڻڄاتل امڪانن لاءِ رستو هموار ڪري سگهي ٿي.
جڏهن اهڙيون خواهشون موجود هونديون آهن، ته صحت جي سار سنڀال جي ڊيٽا جي تشريح ۽ انٽرآپريبلٽي اهم ٿي ويندي آهي. سخت هدايتن ۽ GDPR ۽ HIPAA جهڙين ريگيوليٽري تعميل جي نفاذ سان، جيڪو ناگزير ٿي ويندو آهي اهو آهي صحت جي سار سنڀال جي ڊيٽا جي سڃاڻپ کي ختم ڪرڻ.
اسان اڳ ۾ ئي هڪ وسيع مضمون کي ڍڪي چڪا آهيون ته منظم صحت جي سار سنڀال جي ڊيٽا ۽ غير منظم صحت جي سار سنڀال جي ڊيٽا کي غير واضح ڪرڻ تي. صحت جي سار سنڀال جي ڊيٽا جي سڃاڻپ جي خاتمي تي هڪ وقف (وڌيڪ پڙهو) مضمون پڻ آهي . اسان توهان کي زور ڏيون ٿا ته انهن کي جامع معلومات لاءِ پڙهو ڇو ته اسان وٽ هي مضمون غير منظم ڊيٽا جي سڃاڻپ جي خاتمي تي هڪ خاص مضمون لاءِ هوندو.
غير منظم ٿيل ڊيٽا جي سڃاڻپ ڪرڻ ۾ چئلينج
جيئن نالو مان ظاهر آهي، غير منظم ڊيٽا منظم نه آهي. اهو فارميٽ، فائل جي قسمن، سائيز، تناظر، ۽ ٻين جي لحاظ کان ٽڙيل پکڙيل آهي. صرف حقيقت اها آهي ته غير منظم ڊيٽا آڊيو، ٽيڪسٽ، ميڊيڪل اميجنگ، اينالاگ داخلائن، ۽ ٻين جي صورتن ۾ موجود آهي، اهو سڀ ڪجهه ذاتي معلومات جي سڃاڻپ ڪندڙ (PII) کي سمجهڻ کي وڌيڪ چئلينج ڪري ٿو، جيڪو غير منظم ڊيٽا جي سڃاڻپ ۾ ضروري آهي.
توهان کي بنيادي چئلينج جي هڪ جھلڪ ڏيڻ لاء، هتي هڪ تڪڙو فهرست آهي:

- مفاهمت سمجھڻ - جتي AI اسٽيڪ هولڊر لاءِ اهو ڏکيو آهي ته ڪنهن خاص حصي يا غير ترتيب واري ڊيٽا جي پهلوءَ جي پويان مخصوص حوالي کي سمجهڻ. مثال طور، سمجھڻ ته ڇا نالو ھڪڙي ڪمپني جو نالو آھي، ھڪڙي شخص جو نالو، يا ھڪڙو پراڊڪٽ جو نالو ھڪڙي مشڪوڪ ۾ آڻي سگھي ٿو ته ڇا ان جي سڃاڻپ ٿيڻ گھرجي.
- غير متني ڊيٽا - جتي نالن يا PIIs لاءِ ٻڌڻ يا بصري اشارن جي نشاندهي ڪرڻ هڪ مشڪل ڪم ٿي سگهي ٿو ڇاڪاڻ ته هڪ اسٽيڪ هولڊر کي شايد ڪلاڪن ۽ ڪلاڪن جي فوٽيج يا رڪارڊنگ ذريعي ويهڻو پوندو نازڪ پهلوئن کي رد ڪرڻ جي ڪوشش.
- تڪليف - اهو خاص طور تي اينالاگ ڊيٽا جي حوالي سان صحيح آهي جهڙوڪ ڊاڪٽر جي نسخي يا رجسٽر ۾ اسپتال جي داخلا. هٿ سان لکڻ کان وٺي قدرتي ٻولي ۾ اظهار جي حد تائين، اهو ڊيٽا جي سڃاڻپ کي هڪ پيچيده ڪم ڪري سگهي ٿو.
اڻ سڌريل ڊيٽا ڊي-شناخت بهترين طريقا
غير منظم ڊيٽا مان PIIs کي هٽائڻ جو عمل منظم ڊيٽا جي سڃاڻپ کان بلڪل مختلف آهي پر ناممڪن ناهي. هڪ منظم ۽ لاڳاپيل طريقي سان، غير منظم ڊيٽا جي صلاحيت کي بيحد استعمال ڪري سگهجي ٿو. اچو ته ڏسون ته اهو ڪيئن حاصل ڪري سگهجي ٿو مختلف طريقن سان.
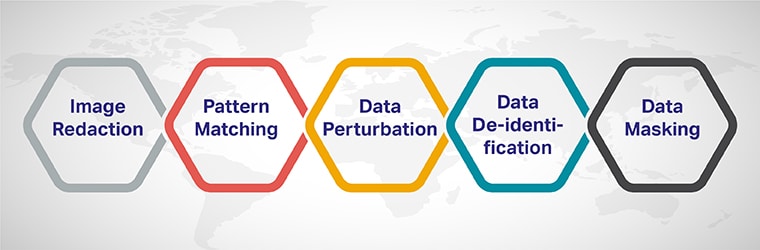
تصوير جي ريڊيڪشن: هي طبي تصويري ڊيٽا جي حوالي سان آهي ۽ ان ۾ مريض جي سڃاڻپ ڪندڙن کي هٽائڻ ۽ تصويرن مان جسماني حوالن ۽ حصن کي ڌوڙ ڪرڻ شامل آهي. انهن کي خاص اکرن سان تبديل ڪيو ويندو آهي ته جيئن تشخيصي ڪارڪردگي ۽ تصويري ڊيٽا جي افاديت کي برقرار رکيو وڃي.
پيٽرن جي ميلاپ: ڪجھ عام PIIs جهڙوڪ نالا، رابطي جي تفصيل، ۽ پتا اڳواٽ بيان ڪيل نمونن جي مطالعي جي حڪمت عملي استعمال ڪندي ڳولي سگهجن ٿا ۽ ختم ڪري سگهجن ٿا.
اختلافي رازداري يا ڊيٽا جي خرابي: هن ۾ شامل آهي ڪنٽرول شور کي لڪائڻ لاءِ ڊيٽا يا خاصيتون جيڪي هڪ فرد ڏانهن واپس ڳولي سگهجن ٿيون. اهو مثالي طريقو نه رڳو ڊيٽا جي سڃاڻپ کي يقيني بڻائي ٿو پر ڊيٽا سيٽ جي شمارياتي ملڪيت کي برقرار رکڻ لاء تجزيو پڻ.
ڊيٽا جي سڃاڻپ ختم ڪرڻ: هي غير منظم ڊيٽا مان PIIs کي هٽائڻ جي سڀ کان وڌيڪ قابل اعتماد ۽ اثرائتي طريقن مان هڪ آهي. اهو ٻن طريقن مان هڪ ۾ لاڳو ڪري سگهجي ٿو:
- نگراني ڪيل تعليم - جتي هڪ ماڊل کي تربيت ڏني وئي آهي متن يا ڊيٽا کي PII يا غير PII جي طور تي درجه بندي ڪرڻ لاءِ
- اڻ سريل تعليم - جتي هڪ ماڊل کي تربيت ڏني وئي آهي خودمختياري سان PII جي سڃاڻپ ۾ نمونن کي ڳولڻ لاءِ
هي طريقو مريض جي رازداري جي حفاظت کي يقيني بڻائي ٿو جڏهن ته ڪم جي سڀ کان وڌيڪ غير ضروري پهلوئن لاءِ انساني مداخلت کي برقرار رکي ٿو. اسٽيڪ هولڊرز ۽ صحت جي سار سنڀال ڊيٽا فراهم ڪندڙ جيڪي غير منظم ڊيٽا کي غير سڃاڻپ ڪرڻ لاءِ ايم ايل ٽيڪنڪ استعمال ڪن ٿا، انهن وٽ صرف انساني طور تي فعال معيار جي يقين ڏياريندڙ عمل ٿي سگهي ٿو ته جيئن نتيجن جي انصاف، مطابقت ۽ درستگي کي يقيني بڻائي سگهجي.
ڊيٽا ماسڪنگ: ڊيٽا ماسڪنگ صحت جي سار سنڀال جي ڊيٽا کي ختم ڪرڻ لاءِ ڊجيٽل لفظي راند آهي، جتي مخصوص سڃاڻپ ڪندڙن کي مخصوص ٽيڪنڪ ذريعي عام يا مبهم بڻايو ويندو آهي جهڙوڪ:
- ٽوڪنائزيشن - ڪردارن يا ٽوڪن سان PIIs جي متبادل کي شامل ڪرڻ
- عام ڪرڻ - مخصوص PII قدرن کي عام / مبہم سان تبديل ڪندي
- ڦيرائڻ - PIIs کي مبهم بڻائڻ لاءِ
بهرحال، هي طريقو هڪ حد سان اچي ٿو ته نفيس نموني يا طريقي سان، ڊيٽا کي ٻيهر سڃاڻي سگهجي ٿو.
مارڪيٽ رانديگرن کي آئوٽ سورسنگ
غير منظم ڊيٽا جي سڃاڻپ جي عمل کي يقيني بڻائڻ جو واحد صحيح طريقو هوائي بند، بيوقوف ۽ HIPAA جي هدايتن تي عمل ڪندڙ آهي، اهو آهي ته ڪمن کي شيپ وانگر هڪ قابل اعتماد سروس فراهم ڪندڙ کي آئوٽ سورس ڪيو وڃي . جديد ماڊلز ۽ سخت معيار جي يقين ڏياريندڙ پروٽوڪول سان، اسان يقيني بڻايون ٿا ته ڊيٽا رازداري ۾ انساني نگراني هر وقت گهٽجي وڃي.
سالن تائين مارڪيٽ تي غالب ڪاروبار هجڻ ڪري، اسان توهان جي منصوبن جي تنقيد کي سمجهون ٿا. تنهن ڪري، اڄ اسان سان رابطو ڪريو پنهنجي صحت جي سارسنڀال کي بهتر ڪرڻ لاءِ صحت جي سار سنڀار واري ڊيٽا سان جيڪا شيپ طرفان سڃاڻپ ڪئي وئي آهي.