تصور ڪريو ته هڪ وائس اسسٽنٽ کي هڪ ڊگهي ملاقات جو خلاصو بيان ڪرڻ، ان کي اسپيني ۾ ترجمو ڪرڻ، ۽ عمل جي شين کي پنهنجي CRM ۾ داخل ڪرڻ لاءِ چيو وڃي ٿو - سڀ هڪ واحد وائس نوٽ مان.
انهيءَ "جادو" جي پويان صرف ويسپر جهڙو طاقتور ماڊل يا جيمني يا چيٽ جي پي ٽي جهڙو ايل ايل ايم ناهي. اهو تقرير جي سڃاڻپ ڊيٽاسيٽ آهي جيڪي انهن ماڊلز کي تربيت ڏيڻ ۽ بهتر ڪرڻ لاءِ استعمال ڪيا ويندا آهن.
2025 ۾، تقرير ۽ آواز جي سڃاڻپ هڪ اربين ڊالرن جي مارڪيٽ آهي، جيڪا 2032 تائين 80 ارب ڊالر کان وڌي ويندي.
جيڪڏهن توهان جو AI پراڊڪٽ ڳالهائيندڙ ان پٽ تي ڀاڙي ٿو - ڇا اهو رابطي سينٽر ڪالز، ڊڪٽيشن، يا وائس سرچ هجي - توهان جي تقرير ڊيٽاسيٽس جي معيار، تنوع، ۽ قانونيت اهو طئي ڪندي ته توهان جو AI ڪيتري سٺي نموني "ٻڌي ٿو".
هن آرٽيڪل ۾، اسين ڳالهائينداسين متنوع اسپيچ ريڪگنيشن ڊيٽا سيٽن بابت. اسان توهان جي AI ماڊل لاءِ بهترين ڊيٽا سيٽ چونڊڻ ۾ مدد لاءِ انهن جا قسم ڳوليندا سين.
پر پهرين، اچو ته ڪجهه بنيادي ڳالهين ۾ وڃو.
تقرير جي سڃاڻپ واري ڊيٽا سيٽ ڇا آهي؟
مثال طور، ٽيڪساس کان هڪ شخص لنڊن ۾ ڪنهن کان مختلف آواز آهي، جيتوڻيڪ اهي ساڳيو جملو چوندا آهن. هڪ سٺو ڊيٽا سيٽ هن تنوع کي پڪڙي ٿو. اهو AI کي ٻڌڻ ۽ سمجهڻ ۾ مدد ڪري ٿو انساني تقرير جي nuances.
هي ڊيٽا سيٽ AI ماڊلز جي ترقي ۾ اهم ڪردار ادا ڪري ٿو. اهو AI لاءِ ٻولي جي فهم ۽ پيداوار سکڻ لاءِ ضروري ڊيٽا مهيا ڪري ٿو. هڪ امير ۽ متنوع ڊيٽا سيٽ سان، هڪ AI ماڊل انساني ٻولي کي سمجهڻ ۽ ان سان لهه وچڙ ۾ وڌيڪ قابل ٿي ويندو آهي. تنهن ڪري، هڪ تقرير جي سڃاڻپ ڊيٽا سيٽ توهان کي ذهانت، جوابي، ۽ صحيح آواز AI ماڊل ٺاهڻ ۾ مدد ڪري سگهي ٿي.
توهان کي معيار جي تقرير جي سڃاڻپ واري ڊيٽا سيٽ جي ضرورت ڇو آهي؟
تقرير-مقامي LLMs جي اڀار سان، نوان ڊيٽاسيٽ قسم ابھري رهيا آهن:
- قدرتي ٻولي جي وضاحتن سان اظهاري تقرير (مثال طور، اسپيچ ڪرافٽ) - تربيتي ماڊلز جي مدد ڪري ٿو جيڪي انداز، جذبات، ۽ عروض کي سمجهن ٿا.
- حقيقي ڊيٽا کي وڌائڻ لاءِ TTS + LLM-جنريٽر ٿيل ٽيڪسٽ (مثال طور، ميگپي اسپيچ) سان ٺهيل مصنوعي اسپيچ ڪارپورا.
- آواز جي سيڪيورٽي ۽ فراڊ جي ڳولا لاءِ جعلي تقرير / اسپوف جي ڳولا ڊيٽاسيٽس (مثال طور، لاما پارٽيشل اسپوف).
جڏهن استعمال ڪريو: توهان تقرير-ٻولي ماڊلز، اظهار ڪندڙ TTS، يا AI حفاظت/جعلي سڃاڻپ تي ڪم ڪري رهيا آهيو.
صحيح تقرير جي سڃاڻپ ڊيٽا سيٽ ڪيئن چونڊيو (قدم بہ قدم)
هن کي عملي فيصلي جي فريم ورڪ طور استعمال ڪريو.
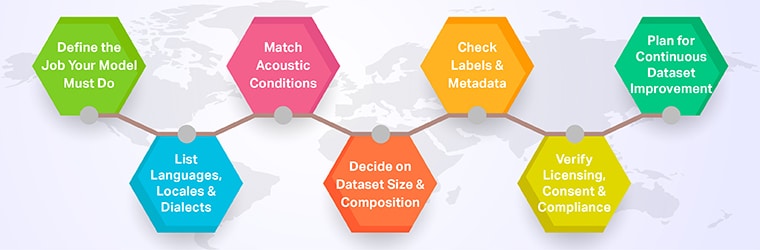
قدم 1 - اهو ڪم بيان ڪريو جيڪو توهان جي ماڊل کي ڪرڻ گهرجي
- ٽاسڪ ڊڪٽيشن، وائس سرچ، ڪانٽيڪٽ سينٽر اينالائيٽڪس، ريئل ٽائيم ڪيپشن، ڪمپلائنس مانيٽرنگ، وغيره.
- چئنل: ٽيليفوني (8 ڪلو هرٽز)، موبائل ايپ، پري فيلڊ سمارٽ اسپيڪر، ڪار ۾ مائڪروفون.
- معيار جو بار: ٽارگيٽ WER، دير، جوابي وقت، ريگيوليٽري گهرجن.
قدم 2 - ٻوليون، مقامي ۽ لهجا لسٽ ڪريو
- ڪهڙيون ٻوليون ۽ مختلف قسمون (مثال طور، آمريڪي انگريزي بمقابله هندستاني انگريزي بمقابله سنگاپور انگريزي)؟
- ڇا توهان کي ضرورت آهي ڪوڊ-مليل تقرير (هندي-انگريزي، اسپيني-انگريزي، وغيره)؟
- ڇا توهان گهٽ وسيلن وارين ٻولين کي نشانو بڻائي رهيا آهيو جتي کليل ڊيٽا گهٽ آهي؟
قدم 3 - صوتي حالتن کي ملائي
- ٽيليفوني بمقابله وائڊ بينڊ بمقابله ملٽي مائيڪ ايريز.
- خاموش آفيس بمقابله شور واري گهٽي بمقابله هلندڙ ڪار.
- ويجهو ميدان بمقابله پري ميدان مائڪروفون.
توهان جو ڊيٽا سيٽ ان ماحول کي ظاهر ڪرڻ گهرجي جنهن ۾ توهان جا استعمال ڪندڙ اصل ۾ هوندا.
قدم 4 - ڊيٽا سيٽ جي سائيز ۽ بناوت تي فيصلو ڪريو
عام اصول (سخت نه):
- اڳ ۾ تربيت يافته ماڊل کي بهتر بنائڻ (سرگوشي، wav2vec2، وغيره)
- درجن کان ڪجهه سو ڪلاڪن تائين اعليٰ معيار، ڊومين سان ملندڙ ڊيٽا سوئي کي تمام گهڻو منتقل ڪري سگهي ٿو.
- شروع کان ماڊل جي تربيت
- عام طور تي هزارين کان ڏهه هزار ڪلاڪن جي ضرورت هوندي آهي، اهو ئي سبب آهي ته ڪيتريون ئي ٽيمون اڳ ۾ تربيت يافته سسٽم کان شروع ٿين ٿيون ۽ ڊيٽا کي بهتر ڪرڻ تي بجيٽ تي ڌيان ڏين ٿيون.
ملايو:
- ڪجهه صاف اسڪرپٽ ٿيل ڊيٽا (بنيادي صوتياتيات، انگن لاءِ).
- حقيقت پسند ڳالهه ٻولهه جو ڊيٽا (مضبوطي لاءِ).
- ڊومين جي مخصوص ايج ڪيسز (نادر ادارا، ڊگها انگ، اصطلاح).
قدم 5 - ليبل ۽ ميٽا ڊيٽا چيڪ ڪريو
ڪلاسيڪل ASR لاءِ، توهان کي گهٽ ۾ گهٽ ضرورت آهي:
- صحيح نقل
- بنيادي اسپيڪر ٽيگ
- مسلسل اوقاف ۽ ڪيسنگ جا قاعدا
LLM + ASR پائپ لائنن لاءِ، توهان کي پڻ گهرجي:
- اسپيڪر جي موڙ واري حصي جي ترتيب (ڪنهن ڇا چيو، ڪڏهن)
- ڪال/ڳالهه ٻولهه نتيجو (حل ٿيل، وڌيل، شڪايت جو قسم)
- اداري جي تشريح (نالا، اڪائونٽ نمبر، پراڊڪٽ جا نالا)
- جتي لاڳاپيل هجي، جذبات يا جذبات جا ٽيگ.
اهي ليبل توهان کي ٽرانسڪرپٽس جي مٿان خلاصو، QA، ڪوچنگ، روٽنگ، ۽ RAG پائپ لائنون ٺاهڻ جي اجازت ڏين ٿا - جتي هاڻي تمام گهڻي ڪاروباري قدر رهي ٿي.
قدم 6 - لائسنسنگ، رضامندي ۽ تعميل جي تصديق ڪريو
تربيت کان اڳ:
- ڇا ڊيٽاسيٽ لائسنس يافته آهي تجارتي استعمال (صرف تحقيق نه)؟
- ڇا اسپيڪرن کي هن استعمال لاءِ ڄاڻ ڏني وئي هئي ۽ رضامندي ڏني وئي هئي؟
- ڇا PII ۽ حساس خاصيتون GDPR / HIPAA / مقامي ضابطن جي مطابق سنڀاليون وينديون آهن؟
ڪيترائي کليل ڊيٽا سيٽ CC-BY يا CC0 جهڙا لائسنس استعمال ڪندا آهن ، هر هڪ مختلف ذميداريون سان. جڏهن شڪ هجي، قانوني جائزي کي هڪ غير ڳالهين لائق قدم طور سمجهيو.
قدم 7 - مسلسل ڊيٽا سيٽ جي بهتري لاءِ منصوبو
ٻوليون ترقي ڪن ٿيون، توهان جي پيداوار ترقي ڪري ٿي، ۽ ائين ئي توهان جو ڊيٽاسيٽ به ترقي ڪري ٿو:
- حقيقي دنيا جي غلطين جي نگراني ڪريو ۽ غلط سڃاڻپ کي پنهنجي تربيتي سيٽ ۾ واپس آڻيو.
- جيئن توهان جو ڊومين تبديل ٿئي ٿو، نوان ادارا (برانڊ، SKU، ريگيوليٽري شرطون) شامل ڪريو.
- تعصب گهٽائڻ لاءِ وقتي طور تي تلفظ ۽ آبادي کي ٻيهر متوازن ڪريو.
هي بند لوپ اڪثر ڪري "ڪافي سٺي" ۽ "مارڪيٽ جي اڳواڻي ڪندڙ" تقرير جي شين جي وچ ۾ سڀ کان وڏو فرق ڪندڙ هوندو آهي.
[پڻ پڙهو: اسان جي معياري هندستاني ٻولي آڊيو ڊيٽاسيٽس سان AI ماڊلز کي وڌايو .]
شيپ ڪيئن مدد ڪري سگھي ٿي
جيڪڏهن توهان "مون کي خبر آهي ته مون کي بهتر تقرير ڊيٽا جي ضرورت آهي، پر مون کي پڪ ناهي ته ڪٿان شروع ڪريان" جي مرحلي تي آهيو ، ته شيپ توهان جي مدد ڪري سگهي ٿو:
- پنھنجي موجوده ڊيٽاسيٽس جي آڊٽ ڪريو ۽ سڃاڻپ ڪريو ڪوريج خلا
- مهيا ڪريو آف دي شيلف تقرير جي سڃاڻپ ڊيٽاسيٽس 65+ ٻولين ۽ درجنين ڊومينز (اسڪرپٽ ٿيل، ڪال سينٽر، ويڪ ورڊس، ٽي ٽي ايس، وغيره) ۾
- ڊيزائن ۽ عمل ڪريو ڪسٽم ڊيٽا گڏ ڪرڻ پروگرام (ريموٽ، ملڪ اندر، ملٽي ڊيوائس)
- رسيء تشريح، نقل، معيار جو ڪنٽرول، ۽ سڃاڻپ ختم ڪرڻ آخر تائين
تنهن ڪري توهان جي ٽيم ماڊلز ۽ پراڊڪٽس تي ڌيان ڏئي سگهي ٿي ، جڏهن ته اسان پڪ ڪريون ٿا ته توهان جي AI وٽ اعليٰ معيار، مطابقت رکندڙ تقرير ڊيٽا آهي جيڪو ان کي ٻڌڻ ۽ سمجهڻ لاءِ گهربل آهي.