اهو طريقو AI کي ڄاڻڻ ۾ مدد ڪري ٿو جڏهن ڪجهه سوالن کان بچڻ لاء. اها درخواستن کي رد ڪرڻ سکي ٿي جنهن ۾ نقصانڪار مواد شامل هجي جهڙوڪ تشدد يا تعصب.
RLHF استعمال ڪندڙ ماڊل جي هڪ مشهور مثال OpenAI جو ChatGPT آهي . هي ماڊل جوابن کي بهتر بڻائڻ ۽ انهن کي وڌيڪ لاڳاپيل ۽ ذميوار بڻائڻ لاءِ انساني راءِ استعمال ڪري ٿو.
انساني راءِ سان سکيا جي مضبوطي جا مرحلا
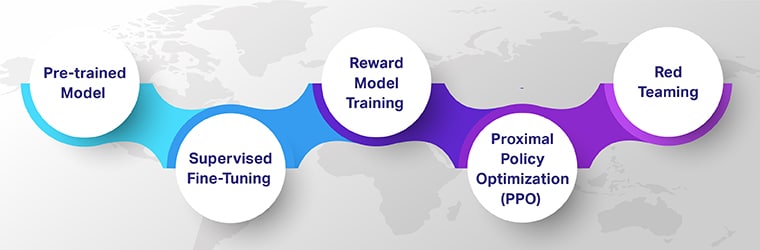
Reinforcement Learning with Human Feedback (RLHF) انهي ڳالهه کي يقيني بڻائي ٿو ته AI ماڊلز ٽيڪنيڪل طور تي ماهر، اخلاقي طور تي صحيح، ۽ حوالي سان لاڳاپيل آهن. RLHF جي پنجن اهم مرحلن ۾ ڏسو جيڪي ڳولھيو ٿا ته اھي نفيس، انساني ھدايت ڪندڙ AI سسٽم ٺاهڻ ۾ ڪيئن مدد ڪن ٿا.
اڳ-تربيت ٿيل ماڊل سان شروع ٿي
RLHF سفر هڪ اڳ-تربيت ٿيل ماڊل سان شروع ٿئي ٿو، انساني-ان-دي-لوپ مشين لرننگ ۾ هڪ بنيادي قدم. شروعاتي طور تي وسيع ڊيٽا سيٽن تي تربيت ڪئي وئي، اهي ماڊل زبان يا ٻين بنيادي ڪمن جي وسيع ڄاڻ رکن ٿا پر ماهرن جي کوٽ ناهي.
ڊولپرز اڳ-تربيت ٿيل ماڊل سان شروع ڪندا آهن ۽ هڪ اهم فائدو حاصل ڪندا آهن. اهي ماڊل اڳ ۾ ئي ڊيٽا جي وسيع مقدار مان سکيا ويا آهن. اهو انهن کي ابتدائي تربيتي مرحلي ۾ وقت ۽ وسيلن کي بچائڻ ۾ مدد ڪري ٿو. هي قدم وڌيڪ مرڪوز ۽ مخصوص تربيت لاءِ اسٽيج سيٽ ڪري ٿو جيڪو هيٺ ڏنل آهي.
نگراني ڪيل فائن ٽيوننگ
ٻئي قدم ۾ نگراني ڪيل فائن ٽيوننگ شامل آهي، جتي اڳ-تربيت ٿيل ماڊل هڪ خاص ڪم يا ڊومين تي اضافي تربيت حاصل ڪري ٿو. هي قدم ليبل ٿيل ڊيٽا استعمال ڪندي خاصيت آهي، جيڪا ماڊل کي وڌيڪ صحيح ۽ لاڳاپيل طور تي لاڳاپيل نتيجا پيدا ڪرڻ ۾ مدد ڪري ٿي.
ھي ٺيڪ ٺاھڻ وارو عمل انساني ھدايت واري AI ٽريننگ جو ھڪ بھترين مثال آھي، جتي انساني فيصلا AI کي گھربل رويي ۽ جوابن ڏانھن ھلائڻ ۾ اھم ڪردار ادا ڪري ٿو. ٽرينرز کي لازمي طور تي ڊومين جي مخصوص ڊيٽا کي چونڊڻ ۽ پيش ڪرڻ گهرجي انهي کي يقيني بڻائڻ لاءِ ته AI هٿ ۾ ڪم جي nuances ۽ مخصوص ضرورتن کي ترتيب ڏئي ٿو.
انعام جي ماڊل ٽريننگ
ٽئين قدم ۾، توهان هڪ الڳ ماڊل ٽرين ڪريو ٿا سڃاڻڻ ۽ انعام ڏيڻ لاءِ گهربل آئوٽ جيڪي AI ٺاهي ٿو. هي قدم مرڪزي آهي راءِ تي ٻڌل AI سکيا.
انعام جو ماڊل AI جي پيداوار جو جائزو وٺندو آهي. اهو معيار جي بنياد تي اسڪينڊل تفويض ڪري ٿو جهڙوڪ مطابقت، درستگي، ۽ ترتيب سان مطلوب نتيجن سان. اهي اسڪور موٽ جي طور تي ڪم ڪن ٿا ۽ اعليٰ معيار جا جواب پيدا ڪرڻ لاءِ AI جي رهنمائي ڪن ٿا. اهو عمل پيچيده يا موضوعي ڪمن جي وڌيڪ نفيس سمجھڻ جي قابل بڻائي ٿو جتي واضح هدايتون موثر تربيت لاءِ ڪافي نه هجن.
Proximal Policy Optimization (PPO) ذريعي مضبوط ڪرڻ واري سکيا
اڳيون، AI Proximal Policy Optimization (PPO) ذريعي رينفورسمينٽ لرننگ مان گذري ٿو، جيڪو انٽرايڪٽو مشين لرننگ ۾ هڪ نفيس الگورٿمڪ طريقو آهي.
پي پي او AI کي اجازت ڏئي ٿو ته ان جي ماحول سان سڌي رابطي مان سکڻ. اهو انعام ۽ ڏنڊن ذريعي پنهنجي فيصلي سازي جي عمل کي بهتر بڻائي ٿو. اهو طريقو حقيقي وقت جي سکيا ۽ موافقت ۾ خاص طور تي اثرائتو آهي، ڇاڪاڻ ته اهو AI کي مختلف حالتن ۾ ان جي عملن جي نتيجن کي سمجهڻ ۾ مدد ڪري ٿو.
پي پي او AI کي پيچيده، متحرڪ ماحول کي نيويگيٽ ڪرڻ لاءِ سيکارڻ ۾ مددگار آهي جتي گهربل نتيجا پيدا ٿي سگهن ٿا يا وضاحت ڪرڻ ڏکيو ٿي سگهي ٿو.
ڳاڙهو ٽيمنگ
آخري مرحلي ۾ AI سسٽم جي سخت حقيقي دنيا جي جاچ شامل آهي. هتي، جائزو وٺندڙن جو هڪ متنوع گروپ، جنهن کي ' ريڊ ٽيم ' سڏيو ويندو آهي، مختلف منظرنامي سان AI کي چئلينج ڪن ٿا. اهي صحيح ۽ مناسب طور تي جواب ڏيڻ جي صلاحيت کي جانچيندا آهن. هي مرحلو يقيني بڻائي ٿو ته AI حقيقي دنيا جي ايپليڪيشنن ۽ غير متوقع حالتن کي سنڀالي سگهي ٿو.
ريڊ ٽيمنگ اي آءِ جي ٽيڪنيڪل مهارت ۽ اخلاقي ۽ باضابطه آواز جي جانچ ڪري ٿي. انهن کي يقيني بڻائي ٿو ته اهو قابل قبول اخلاقي ۽ ثقافتي حدن جي اندر هلندو آهي.
انهن سڀني مرحلن دوران، RLHF AI ترقي جي هر مرحلي تي انساني شموليت جي اهميت تي زور ڏئي ٿو. ابتدائي تربيت جي رهنمائي ڪرڻ کان وٺي احتياط سان تيار ڪيل ڊيٽا سان nuanced موٽ ۽ سخت حقيقي دنيا جي جاچ مهيا ڪرڻ تائين، انساني ان پٽ AI سسٽم ٺاهڻ لاءِ لازمي آهي جيڪي ذهين، ذميوار، ۽ انساني قدرن ۽ اخلاقيات سان لاڳاپيل آهن.
ٿڪل
Reinforcement Learning with Human Feedback (RLHF) AI ۾ هڪ نئين دور کي ڏيکاري ٿو جيئن اهو انساني بصيرت کي مشين لرننگ سان گڏ وڌيڪ اخلاقي، درست AI سسٽم لاءِ.
RLHF AI کي وڌيڪ جذباتي، جامع، ۽ جديد بڻائڻ جو واعدو ڪيو. اهو تعصب کي حل ڪري سگهي ٿو ۽ مسئلا حل ڪرڻ کي وڌائي سگھي ٿو. اهو صحت جي سار سنڀار، تعليم، ۽ ڪسٽمر سروس وانگر علائقن کي تبديل ڪرڻ لاء مقرر ڪيو ويو آهي.
بهرحال، هن طريقي کي بهتر ڪرڻ لاءِ تاثير، انصاف، ۽ اخلاقي ترتيب کي يقيني بڻائڻ لاءِ جاري ڪوششن جي ضرورت آهي.