

نالي واري وجود جي سڃاڻپ متن جي اسپن کي اڳواٽ بيان ڪيل زمرن ۾ سڃاڻي ٿي ۽ ان کي درجه بندي ڪري ٿي. نالي واري وجود جي سڃاڻپ قدرتي ٻولي پروسيسنگ (NLP) ٽيڪنڪ آهي جيڪا سادي متن اندر اهم حقيقتون ڳولي ٿي ۽ ليبل ڪري ٿي ته اهي ڇا آهن - هڪ شخص، هڪ تنظيم، هڪ جڳهه، هڪ تاريخ، يا هڪ ڊالر جي رقم. نالي واري وجود جي سڃاڻپ (NER) NLP جو ڪم آهي ته غير منظم متن ۾ "نام ٿيل وجودن" کي ڳولڻ ۽ انهن کي اڳواٽ بيان ڪيل زمرن ۾ ترتيب ڏيڻ. "NER مڪمل فارم" کي صرف نالي واري وجود جي سڃاڻپ سڏيو ويندو آهي، ۽ اهو ان جي دل ۾ ويٺو آهي ته مشينون خام ٻولي کي منظم، استعمال لائق ڊيٽا ۾ ڪيئن تبديل ڪن ٿيون.
هاڻي هي ڇو اهم آهي؟ ڇاڪاڻ ته متن جي اندر ويٺل قدر ڦاٽي رهي آهي. عالمي اين ايل پي مارڪيٽ جي قيمت 2024 ۾ 59.70 بلين آمريڪي ڊالر هئي ۽ 2030 تائين 439.85 بلين آمريڪي ڊالر تائين پهچڻ جو امڪان آهي، جيڪو 38.7٪ سي اي جي آر (گرينڊ ويو ريسرچ، 2024) آهي . اين اي آر ان واڌ کي هلائڻ واري ڪمن مان هڪ آهي، خاموشي سان سرچ انجن، چيٽ بوٽس، ۽ ڪلينڪل ڊيٽا پائپ لائنز کي طاقت ڏئي رهيو آهي.
NER کي هڪ هاءِ لائيٽر وانگر سوچيو جيڪو هڪ ئي وقت ٻه ڪم ڪري ٿو: اهو اهم لفظن کي نشان لڳائي ٿو ۽ حاشيي ۾ هڪ نوٽ لکي ٿو ته هر هڪ ڇا آهي. هڪ انسان اهو فطري طور تي ڪندو آهي. "اسٽيو جابز" ٻڌو، ۽ توهان فوري طور تي هڪ شخص، ايپل، ڪيليفورنيا سان ڳنڍيو. ڪمپيوٽر ۾ اهڙي ڪا به جبلت ناهي - ان کي انهن ڪيٽيگريز کي ڏسڻ لاءِ تربيت ڏيڻي پوندي آهي، ۽ اها تربيت اها آهي جتي معيار جو ڊيٽا ڳرو ڪم ڪندو آهي.
صحت جي سار سنڀال ۾، ڪلينڪل اين اي آر غير منظم نوٽس مان حالتون، دوائون، دوائون، طريقا، جسماني سائيٽون، ليبارٽري قدر ۽ وقتي اظهار ڪڍي ٿو، پوءِ انهن کي ICD-10-CM، CPT، SNOMED CT ۽ RxNorm جهڙن معيارن تي نارمل ڪري ٿو ته جيئن آئوٽ پُٽ مشين ذريعي پڙهڻ لائق ۽ آڊٽ لائق هجي.
ڪيٻئي جا رستا
- NER متن ۾ ادارن - ماڻهن، تنظيمن، جڳهن، تاريخن - جي سڃاڻپ ۽ درجه بندي ڪري ٿو.
- "NER مڪمل فارم" کي "هستي جي سڃاڻپ" جو نالو ڏنو ويو آهي، هڪ بنيادي NLP ڪم.
- جديد اين اي آر گهڻو ڪري ڊيپ لرننگ ۽ ٽرانسفارمر ماڊلز جهڙوڪ BERT تي ڀاڙي ٿو.
- ٽيگنگ اسڪيمون جهڙوڪ BIO ۽ IOBES هر اداري جي شروعات ۽ اختتام جي نشاندهي ڪن ٿيون.
- NER معيار اعليٰ معيار، چڱي طرح بيان ڪيل تربيتي ڊيٽا تي منحصر آهي.
- عام استعمال: ڳولا، چيٽ بوٽس، صحت جي سار سنڀال جا رڪارڊ، ماليات، ۽ قانوني جائزو.
نالي واري اداري جي سڃاڻپ (NER) ڇا آهي؟
نالي واري وجود جي سڃاڻپ قدرتي ٻولي جي پروسيسنگ جو هڪ حصو آهي. اين اي آر جو بنيادي مقصد منظم ۽ غير منظم ڊيٽا کي پروسيس ڪرڻ ۽ انهن نالي واري وجود کي اڳواٽ بيان ڪيل درجابندي ۾ درجه بندي ڪرڻ آهي. ڪجهه عام درجابندي ۾ نالو، مقام، ڪمپني، وقت، مالي قدر، واقعا، ۽ وڌيڪ شامل آهن.
مختصر طور تي، NER سان واسطو رکي ٿو:
- نالي واري اداري جي سڃاڻپ/پڇاڙ - دستاويز ۾ هڪ لفظ يا لفظن جي سيريز جي سڃاڻپ.
- نالي واري اداري جي درجه بندي - هر معلوم ٿيل اداري کي اڳواٽ بيان ڪيل درجابندي ۾ ورهائڻ.
پر NER ڪيئن اين ايل پي سان لاڳاپيل آهي؟
قدرتي ٻولي پروسيسنگ ذهين مشينون ٺاهڻ ۾ مدد ڪري ٿي جيڪي تقرير ۽ متن مان مطلب ڪڍڻ جي قابل آهن. مشين لرننگ انهن ذهين سسٽم کي قدرتي ٻولي ڊيٽاسيٽس جي وڏي مقدار تي تربيت ڏيندي سکيا جاري رکڻ ۾ مدد ڪري ٿي.
عام طور تي، اين ايل پي ٽن وڏن قسمن تي مشتمل آهي:
- ٻوليءَ جي جوڙجڪ ۽ ضابطن کي سمجھڻ- ڪنٽرڪس
- لفظن، متن ۽ تقرير جي معنيٰ ڪڍڻ ۽ انهن جي رشتن جي نشاندهي ڪرڻ- سامونڊيات
- ڳالهايل لفظن کي سڃاڻڻ ۽ انهن کي متن ۾ تبديل ڪرڻ - تقرير
NER مدد ڪري ٿو NLP جي معنيٰ واري حصي ۾، لفظن جي معنيٰ ڪڍڻ، انھن کي سڃاڻڻ ۽ انھن جي لاڳاپن جي بنياد تي.
عام NER ادارن جي قسمن ۾ هڪ گہرے غوطه
نالي واري اداري جي سڃاڻپ ماڊل ادارن کي مختلف اڳواٽ بيان ڪيل قسمن ۾ ورهائي ٿو. NER کي مؤثر طريقي سان استعمال ڪرڻ لاءِ انھن قسمن کي سمجھڻ تمام ضروري آھي. هتي ڪجھ سڀ کان وڌيڪ عام ماڻهن تي هڪ ويجهي نظر آهي:
- شخص (PER): ماڻهن جي نالن کي سڃاڻي ٿو، جنهن ۾ پهريون، وچين ۽ آخري نالا، لقب، ۽ اعزاز شامل آهن. مثال: نيلسن منڊيلا، ڊاڪٽر جين ڊي
- تنظيم (ORG): ڪمپنين، ادارن، سرڪاري ادارن، ۽ ٻين منظم گروپن کي سڃاڻي ٿو. مثال: گوگل، ورلڊ هيلٿ آرگنائيزيشن، اقوام متحده
- جڳھ (LOC): جغرافيائي جڳهن کي ڳولي ٿو، بشمول ملڪن، شهرن، رياستن، پتا، ۽ نشانن جا نشان. مثال: لنڊن، مائونٽ ايورسٽ، ٽائمز اسڪوائر
- تاريخ (DATE): مختلف شڪلين ۾ تاريخون ڪڍي ٿو. مثال: جنوري 1، 2024، 2024-01-01
- وقت (TIME): وقت جي اظهار کي سڃاڻي ٿو. مثال: 3:00 PM، 15:00
- مقدار (QUANTITY): ماپ جي عددي مقدار ۽ يونٽن کي سڃاڻي ٿو. مثال: 10 ڪلوگرام، 2 ليٽر
- سيڪڙو (PERCENT): فيصد معلوم ڪري ٿو. مثال: 50٪، 0.5
- پئسا (پيسا): مالي قدر ۽ ڪرنسي ڪڍي ٿو. مثال: $100، €50
- ٻيا (MISC): هڪ ڪيچ-سڀ قسم جي ادارن لاءِ جيڪي ٻين قسمن ۾ نه ٿا اچن. مثال: نوبل انعام، آئي فون 15″
نالي واري اداري جي سڃاڻپ جا مثال
اڳواٽ مقرر ٿيل اداري جي درجه بندي جا ڪجھ عام مثال هي آهن:
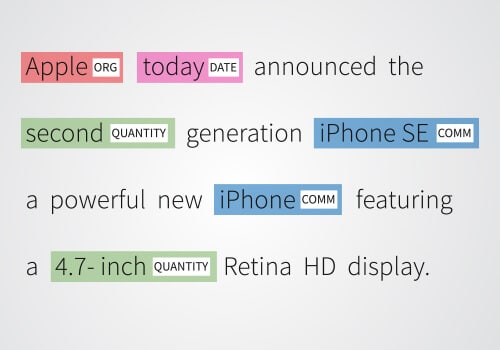
ايپل: کي ORG (تنظيم) طور ليبل ڪيو ويو آهي ۽ ڳاڙهي رنگ ۾ نمايان ڪيو ويو آهي. اڄ: کي DATE طور ليبل ڪيو ويو آهي ۽ گلابي رنگ ۾ نمايان ڪيو ويو آهي. ٻيو: کي QUANTITY طور ليبل ڪيو ويو آهي ۽ سائي رنگ ۾ نمايان ڪيو ويو آهي. آئي فون SE: کي COMM (تجارتي پراڊڪٽ) طور ليبل ڪيو ويو آهي ۽ نيري رنگ ۾ نمايان ڪيو ويو آهي. 4.7 انچ: کي QUANTITY طور ليبل ڪيو ويو آهي ۽ سائي رنگ ۾ نمايان ڪيو ويو آهي.
نالي واري اداري جي سڃاڻپ ۾ ابهام
اصطلاح جنهن درجي سان تعلق رکي ٿو، انسانن لاءِ وجداني طور تي بلڪل واضح آهي. بهرحال، اهو معاملو ڪمپيوٽرن سان نه آهي - اهي درجي بندي جي مسئلن کي منهن ڏين ٿا. مثال طور:
مانچسٽر سٽي ( آرگنائيزيشن ) پريميئر ليگ ٽرافي کٽي جڏهن ته هيٺ ڏنل جملي ۾ تنظيم کي مختلف طريقي سان استعمال ڪيو ويو آهي. مانچسٽر سٽي ( مقام ) هڪ ٽيڪسٽائل ۽ صنعتي پاور هائوس هو.
توهان جي NER ماڊل کي صحيح اداري ڪڍڻ لاءِ تربيتي ڊيٽا جي ضرورت آهي ۽ سکيا ٿيل نمونن جي بنياد تي نامزد ادارن کي درجه بندي ڪري ٿو. جيڪڏهن توهان پنهنجي ماڊل کي شيڪسپيئر انگريزي تي تربيت ڏئي رهيا آهيو، چوڻ جي ضرورت ناهي، ته اهو انسٽاگرام کي سمجهڻ جي قابل نه هوندو. NER ماڊلز جو جائزو انهن جي اڳڪٿين کي زميني سچائي جي تشريح سان مقابلو ڪندي ڪيو ويندو آهي، جيڪي ڊيٽاسيٽ ۾ صحيح، دستي طور تي ليبل ٿيل ادارا آهن.
نالي واري وجود جي سڃاڻپ ڪيئن ڪم ڪندي آهي؟
نالي واري اداري جي سڃاڻپ (NER) جي دائري ۾ داخل ٿيڻ ڪيترن ئي مرحلن تي مشتمل هڪ منظم سفر کي ظاهر ڪري ٿو:
-
ٽوڪنائيزيشن
شروعاتي طور تي، متن جي ڊيٽا کي ننڍڙن يونٽن ۾ ورهايو ويندو آهي، ٽوڪن کي سڏيو ويندو آهي، جيڪي لفظن کان جملن تائين رينج ڪري سگھن ٿا. مثال طور، بيان ”بارڪ اوباما آمريڪا جو صدر هو“ کي ٽوڪن ۾ ورهايو ويو آهي جهڙوڪ ”بارڪ“، ”اوباما“، ”هو“، ”دي“، ”صدر“، ”جي“، ”دي“، ۽ ” آمريڪا“.
-
اداري جي چڪاس
لساني ھدايتن ۽ شمارياتي طريقن جي ھڪڙي ٺھيل کي استعمال ڪندي، امڪاني نالن جي ادارن کي روشني ڏني وئي آھي. نالن ۾ سرمائيداري جي نمونن کي سڃاڻڻ ("بارڪ اوباما") يا مختلف شڪلين (جهڙوڪ تاريخون) هن اسٽيج ۾ اهم آهي.
-
اداري جي درجه بندي
پوسٽ ڳولڻ، ادارن کي اڳواٽ بيان ڪيل ڀاڱن ۾ ترتيب ڏنو ويو آهي جهڙوڪ "شخص"، "تنظيم"، يا "مقام". مشين لرننگ ماڊل، ليبل ٿيل ڊيٽا سيٽن تي پرورش، اڪثر ڪري هن درجه بندي کي هلائيندا آهن. هتي، "بارڪ اوباما" کي "شخص" ۽ "آمريڪا" کي "مقام" طور ٽيگ ڪيو ويو آهي.
-
لاڳاپيل اڀياس
NER سسٽم جي صلاحيت اڪثر ڪري ڀرپاسي جي حوالي سان جائزو وٺڻ سان وڌايو ويندو آهي. مثال طور، جملي ۾ "واشنگٽن هڪ تاريخي واقعي جو شاهد آهي"، حوالو هڪ شخص جي نالي جي بدران "واشنگٽن" کي جڳهه طور سمجهڻ ۾ مدد ڪري ٿو.
-
پوسٽ-تشخيص جي اصلاح
ابتدائي سڃاڻپ ۽ درجه بندي جي پٺيان، هڪ پوسٽ-تشخيص ريفائنمينٽ شايد نتيجن کي هٽائڻ لاءِ. هي مرحلو مونجهارن کي حل ڪري سگهي ٿو، ملٽي ٽوڪن ادارن کي فيوز ڪري سگهي ٿو، يا علم جي بنيادن کي استعمال ڪري اداري جي ڊيٽا کي وڌائڻ لاءِ.
هي بيان ڪيل طريقو نه رڳو NER جي بنيادي کي غير واضح ڪري ٿو پر سرچ انجڻ لاءِ مواد کي به بهتر ڪري ٿو، ان پيچيده عمل جي نمائش کي وڌائي ٿو جيڪو NER کي شامل ڪري ٿو.
مکيه NER طريقا ڪهڙا آهن؟
اين اي آر ماڊل جو بنيادي مقصد ٽيڪسٽ دستاويزن ۾ ادارن کي ليبل ڪرڻ ۽ انهن کي درجه بندي ڪرڻ آهي. هيٺيان ٽي طريقا عام طور تي هن مقصد لاءِ استعمال ڪيا ويندا آهن. جڏهن ته، توهان هڪ يا وڌيڪ طريقن کي گڏ ڪرڻ جو انتخاب پڻ ڪري سگهو ٿا. اين اي آر سسٽم ٺاهڻ جا مختلف طريقا آهن:

لغت تي ٻڌل سسٽم
ڊڪشنري تي ٻڌل سسٽم شايد NER جو سڀ کان سادو ۽ بنيادي طريقو آھي. اهو ڪيترن ئي لفظن، مترادفات، ۽ لفظن جي مجموعن سان هڪ لغت استعمال ڪندو. سسٽم چيڪ ڪندو ته ڇا متن ۾ موجود هڪ خاص وجود لفظ ۾ پڻ موجود آهي. اسٽرنگ ملائيندڙ الگورٿم استعمال ڪندي، ادارن جي ڪراس چيڪنگ ڪئي ويندي آهي.
هن طريقي کي استعمال ڪرڻ جي هڪ خرابي اها آهي ته NER ماڊل جي اثرائتي ڪم لاءِ لفظي ڊيٽا سيٽ کي مسلسل اپڊيٽ ڪرڻ جي ضرورت آهي.
ضابطن تي ٻڌل نظام
هن طريقي ۾، معلومات ڪڍيا ويا آهن اڳوڻي مقرر ڪيل قاعدن جي هڪ سيٽ جي بنياد تي. استعمال ٿيل اصولن جا ٻه بنيادي سيٽ آھن،
نموني تي ٻڌل قاعدا - جيئن نالو مشورو ڏئي ٿو، هڪ نموني تي ٻڌل قاعدو هڪ مورفولوجيڪل نموني يا دستاويز ۾ استعمال ٿيندڙ لفظن جي تار جي پيروي ڪري ٿو.
سياق تي ٻڌل قاعدا - سياق تي ٻڌل قاعدا دستاويز ۾ لفظ جي معنيٰ يا سياق تي منحصر آهن.
مشين لرننگ تي ٻڌل سسٽم
مشين لرننگ تي ٻڌل سسٽم ۾، انگن اکرن جي ماڊلنگ کي ادارن کي ڳولڻ لاءِ استعمال ڪيو ويندو آهي. هن طريقي ۾ ٽيڪسٽ دستاويز جي هڪ خاصيت تي ٻڌل نمائندگي استعمال ڪئي ويندي آهي. توهان پهرين ٻن طريقن جي ڪيترن ئي خامين کي دور ڪري سگهو ٿا ڇاڪاڻ ته ماڊل انهن جي اسپيلنگ ۾ معمولي تبديلين جي باوجود ادارن جي قسمن کي سڃاڻي سگهي ٿو.
گپ سکيا
NER لاءِ گہرا سکيا جا طريقا نيورل نيٽ ورڪن جي طاقت کي استعمال ڪن ٿا جهڙوڪ RNNs ۽ ٽرانسفارمرز کي سمجھڻ لاءِ ڊگھي مدت جي متن جي انحصار کي. انهن طريقن کي استعمال ڪرڻ جو اهم فائدو اهو آهي ته اهي وڏي پئماني تي NER ڪمن لاءِ مناسب آهن جن سان گڏ وڏي تعداد ۾ تربيتي ڊيٽا.
ان کان علاوه، اهي پاڻ کي ڊيٽا مان پيچيده نمونن ۽ خاصيتون سکي سگهن ٿا، دستي تربيت جي ضرورت کي ختم ڪندي. پر اتي هڪ پڪڙي آهي. انهن طريقن کي تربيت ۽ تعیناتي لاءِ وڏي تعداد ۾ ڪمپيوٽري طاقت جي ضرورت هوندي آهي.
هائبرڊ طريقا
اهي طريقا قاعدن جي بنياد تي، شمارياتي، ۽ مشين لرننگ جي طريقن کي گڏ ڪن ٿا نامزد ادارن کي ڪڍڻ لاء. مقصد هر طريقي جي طاقت کي گڏ ڪرڻ آهي جڏهن ته انهن جي ڪمزورين کي گهٽائڻ. هائبرڊ طريقن کي استعمال ڪرڻ جو بهترين حصو اهو لچڪ آهي جيڪو توهان ڪيترن ئي ٽيڪنالاجي کي ضم ڪندي حاصل ڪيو جنهن جي ذريعي توهان مختلف ڊيٽا ذريعن مان ادارا ڪڍي سگهو ٿا.
تنهن هوندي، اتي هڪ امڪان آهي ته اهي طريقا ختم ٿي سگهن ٿا وڌيڪ پيچيده طريقي سان اڪيلو طريقن جي ڀيٽ ۾، جڏهن توهان ڪيترن ئي طريقن کي ضم ڪندا آهيو، ڪم فلو شايد پريشان ٿي سگهي ٿي.
NER ڪٿي استعمال ٿيندو آهي؟ مٿيان استعمال جا ڪيس ۽ صنعتون
نالي واري وجود جي سڃاڻپ (NER) جي ورسٽائلٽي کي ظاهر ڪرڻ.
NER مختلف شعبن ۾ لاڳو ڪيو ويندو آهي، فنانس کان وٺي صحت جي سار سنڀال تائين، ان جي موافقت ۽ وسيع افاديت جو مظاهرو ڪندي.
- چٽ بوٽس چيٽ بوٽس جهڙوڪ GPT کي اهم ادارن جي سڃاڻپ ڪندي صارف جي سوالن کي سمجهڻ ۾.
- گراهڪ جي حمايت پراڊڪٽ طرفان راءِ کي درجه بندي ڪري ٿو، جوابي وقت کي تيز ڪرڻ.
- ناڻو: مالي رپورٽن مان اهم ڊيٽا ڪڍي ٿو، رجحان جي تجزيو ۽ خطري جي تشخيص لاء.
- صحت جي سار سنڀار: اليڪٽرانڪ هيلٿ ريڪارڊ (EHR) مان مريضن جو ڊيٽا ڪڍڻ.
- HR: درخواست ڏيندڙ پروفائلز کي اختصار ڪندي ۽ راءِ جي چينلنگ ذريعي ڀرتي کي منظم ڪري ٿو.
- خبرون مهيا ڪندڙ: مواد کي لاڳاپيل معلومات ۾ درجه بندي ڪري ٿو، رپورٽنگ کي تيز ڪرڻ.
- سفارش انجڻ: ڪمپنيون جهڙوڪ Netflix استعمال ڪن ٿيون NER کي ذاتي ڪرڻ لاءِ سفارشون صارف جي رويي جي بنياد تي.
- سرچ انجڻ: ويب مواد کي ترتيب ڏيڻ سان، NER ڳولا جي نتيجن جي درستگي کي وڌائي ٿو.
- جذبي جو تجزيو: Extracts برانڊ جو ذڪر جائزو کان، جذبي جي تجزياتي اوزار کي تيز ڪرڻ.
- اي ڪامرس: ذاتي شاپنگ تجربن کي وڌائڻ.
- قانوني: معاهدن ۽ قانوني دستاويزن جو تجزيو ڪرڻ.
NER ذريعي ڪڍيل ادارن کي علم جي گراف ۾ ضم ڪري سگهجي ٿو، بهتر ڊيٽا تنظيم ۽ حاصل ڪرڻ کي فعال بڻائي ٿو.
ڪير استعمال ڪري ٿو نالي واري اداري جي سڃاڻپ (NER)؟
اين اي آر (Named Entity Recognition) طاقتور قدرتي ٻولي پروسيسنگ (NLP) ٽيڪنڪ مان هڪ آهي، مختلف صنعتن ۽ ڊومينز ۾ پنهنجو رستو ٺاهيو آهي. تنظيمون اڪثر ڪري معلومات ڪڍڻ کي خودڪار ڪرڻ ۽ ڪارڪردگي کي بهتر بڻائڻ لاءِ هڪ نالي واري اداري جي سڃاڻپ سسٽم کي استعمال ڪنديون آهن. هتي ڪجهه مثال آهن:
- سرچ انجڻ: NER جديد دور جي سرچ انجن جهڙوڪ گوگل ۽ بنگ جو هڪ بنيادي جزو آهي. اهو ويب پيجز ۽ سرچ سوالن مان ادارن کي سڃاڻڻ ۽ درجه بندي ڪرڻ لاءِ استعمال ڪيو ويندو آهي ته جيئن وڌيڪ لاڳاپيل ڳولا جا نتيجا مهيا ڪري سگهجن. مثال طور، NER جي مدد سان، سرچ انجن "ايپل" ڪمپني بمقابله "ايپل" ميوو جي وچ ۾ فرق ڪري سگهي ٿو. صحيح ۽ حوالي سان واقف نتيجا پهچائڻ لاءِ NER عمل جو نفاذ اهم آهي.
- چٽ بوٽس چيٽ بوٽس ۽ اي آءِ اسسٽنٽ صارف جي سوالن مان اهم ادارن کي سمجهڻ لاءِ NER استعمال ڪري سگهن ٿا. ائين ڪرڻ سان، چيٽ بوٽس وڌيڪ صحيح جواب ڏئي سگهن ٿا. مثال طور، جيڪڏهن توهان پڇو ٿا ته "سينٽرل پارڪ جي ويجهو اطالوي ريسٽورنٽ ڳوليو" ته چيٽ بوٽ "اطالوي" کي کاڌي جي قسم، "ريسٽورنٽ" کي جڳهه، ۽ "سينٽرل پارڪ" کي جڳهه طور سمجهندو. NER عمل انهن سسٽم کي لاڳاپيل معلومات کي موثر طريقي سان ڪڍڻ جي قابل بڻائي ٿو.
- تحقيقاتي صحافت: انٽرنيشنل ڪنسورشيم آف انويسٽيگيٽو جرنلسٽس (ICIJ)، هڪ مشهور ميڊيا تنظيم اين اي آر کي پاناما پيپرز جو تجزيو ڪرڻ لاءِ استعمال ڪيو، 11.5 ملين مالي ۽ قانوني دستاويزن جي وڏي ليڪ. انهي صورت ۾، اين اي آر استعمال ڪيو ويو خودڪار طور تي ماڻهن، تنظيمن، ۽ هنڌن جي سڃاڻپ ڪرڻ لاء لکين غير منظم ٿيل دستاويزن، آف شور ٽيڪس چوري جي لڪيل نيٽ ورڪ کي بي نقاب ڪرڻ.
- حياتياتي معلومات: بايو انفارميٽڪس جي شعبي ۾، اين اي آر کي بايو ميڊيڪل ريسرچ پيپرز ۽ ڪلينڪل ٽرائل رپورٽن مان اهم ادارن جهڙوڪ جينز، پروٽين، دوائون ۽ بيمارين کي ڪڍڻ لاءِ استعمال ڪيو ويندو آهي. اهڙو ڊيٽا دوا جي دريافت جي عمل کي تيز ڪرڻ ۾ مدد ڪري ٿو. وڏي بايو ميڊيڪل ڪارپورا تي ماڊلز جي پري ٽريننگ هن خاص ڊومين ۾ اين اي آر سسٽم جي ڪارڪردگي کي خاص طور تي بهتر بڻائي سگهي ٿي.
- سوشل ميڊيا مانيٽرنگ: سوشل ميڊيا تي برانڊ NER استعمال ڪندا آهن ته جيئن انهن جي اشتهاري مهم جي مجموعي ميٽرڪس کي ٽريڪ ڪري سگهجي ۽ انهن جا حریف ڪيئن ڪري رهيا آهن. مثال طور، هڪ ايئر لائن آهي جيڪا NER استعمال ڪندي انهن جي برانڊ جو ذڪر ڪندڙ ٽوئيٽس جو تجزيو ڪري ٿي. اهو هڪ خاص ايئرپورٽ تي "گم ٿيل سامان" جهڙين ادارن جي چوڌاري منفي تبصري کي ڳولي ٿو ته جيئن اهي مسئلي کي جلد کان جلد حل ڪري سگهن. NER عمل سوشل ميڊيا ڊيٽا جي وڏي مقدار مان قابل عمل بصيرت ڪڍڻ لاءِ ضروري آهي.
- لاڳاپيل اشتهار: اشتهاري پليٽ فارم NER استعمال ڪن ٿا ويب صفحن مان اهم ادارن کي ڪڍڻ لاءِ ته جيئن مواد سان گڏ وڌيڪ لاڳاپيل اشتهار ڏيکاري سگهجن، آخرڪار اشتهار جي ٽارگيٽنگ ۽ ڪلڪ-ٿرو ريٽ کي بهتر بڻائي سگهجي. مثال طور، جيڪڏهن NER سفري بلاگ تي "هوائي"، "هوٽل"، ۽ "ساحل" کي ڳولي ٿو، ته اشتهار پليٽ فارم عام هوٽل زنجيرن جي بدران هوائي ريسارٽس لاءِ ڊيل ڏيکاريندو.
- ڀرتي ۽ ٻيهر اسڪريننگ: توهان NER کي هدايت ڪري سگهو ٿا ته توهان کي درخواست ڏيندڙ جي مهارت جي سيٽ، تجربي ۽ پس منظر جي بنياد تي صحيح گهربل صلاحيتون ۽ قابليتون ڳولي. مثال طور، هڪ ڀرتي ايجنسي اميدوارن کي خودڪار طريقي سان ملائڻ لاءِ NER استعمال ڪري سگهي ٿي. ڪمپنيون مخصوص گهرجن مطابق ٺهيل پنهنجا ماڊل استعمال ڪري سگهن ٿيون، يا پنهنجي نالي واري اداري جي سڃاڻپ واري نظام جي درستگي کي وڌائڻ لاءِ اڳ ۾ تربيت يافته ماڊل استعمال ڪري سگهن ٿيون.
صنعتن ۾ نالي واري اداري جي سڃاڻپ (NER) جون درخواستون
NER وٽ قدرتي ٻولي پروسيسنگ ۽ مشين لرننگ ۽ ڊيپ لرننگ حلن لاءِ تربيتي ڊيٽا سيٽ ٺاهڻ سان لاڳاپيل ڪيترن ئي شعبن ۾ ڪيترائي استعمال ڪيس آهن. هڪ تربيت يافته ماڊل نئين ڊيٽا تي NER انجام ڏيڻ لاءِ استعمال ڪيو ويندو آهي، جيڪو متن جي وڏي مقدار مان ادارن جي خودڪار ڪڍڻ کي فعال بڻائي ٿو. ڪجھ ايپليڪيشنون آهن:
ڪسٽمر حمايت
هڪ NER سسٽم آساني سان لاڳاپيل ڪسٽمر شڪايتون، سوالن، ۽ راء جي بنياد تي اهم معلومات جي بنياد تي ڪري سگهي ٿو جهڙوڪ پراڊڪٽ جا نالا، وضاحتون، شاخ جي جڳھ، ۽ وڌيڪ. شڪايت يا راءِ مناسب طور تي درجه بندي ڪئي وئي آهي ۽ ترجيحي لفظن کي فلٽر ڪندي صحيح کاتي ڏانهن موڙيو ويو آهي.
موثر انساني وسيلن
NER انساني وسيلن جي ٽيمن جي مدد ڪري ٿي انھن جي ملازمت جي عمل کي بھتر ڪرڻ ۽ ٽائم لائنن کي گھٽائڻ سان جلدي درخواست ڏيندڙن جي ريزيومز جو خلاصو. NER اوزار ريزيوم کي اسڪين ڪري سگھن ٿا ۽ لاڳاپيل معلومات ڪڍي سگھن ٿا - نالو، عمر، پتو، قابليت، ڪاليج، وغيره.
اضافي طور تي، HR ڊپارٽمينٽ NER اوزار پڻ استعمال ڪري سگھن ٿا اندروني ڪم فلوز کي منظم ڪرڻ لاءِ ملازمن جي شڪايتن کي فلٽر ڪندي ۽ انهن کي لاڳاپيل کاتي جي سربراهن ڏانهن موڪليو.
مواد جي درجه بندي
خبرن جي فراهم ڪندڙن لاءِ مواد جي درجه بندي هڪ تمام وڏو ڪم آهي. مواد کي مختلف قسمن ۾ ورهائڻ سان دريافت ڪرڻ، بصيرت حاصل ڪرڻ، رجحانن جي سڃاڻپ ڪرڻ ۽ موضوعن کي سمجهڻ آسان ٿي ويندو آهي. هڪ نالي وارو وجود جي سڃاڻپ وارو اوزار خبرن جي فراهم ڪندڙن لاءِ ڪارآمد ٿي سگهي ٿو. اهو ڪيترن ئي مضمونن کي اسڪين ڪري سگهي ٿو، ترجيحي ڪي ورڊز جي سڃاڻپ ڪري سگهي ٿو، ۽ ماڻهن، تنظيم، مقام، ۽ وڌيڪ جي بنياد تي معلومات ڪڍي سگهي ٿو.
سرچ انجڻ کي بهتر ڪرڻ

صحيح مواد جي سفارش
ڪيتريون ئي جديد ايپليڪيشنون NER ٽولز تي ڀاڙين ٿيون ته بهتر ۽ ڪسٽمائيز ڪسٽمر تجربو پهچائڻ لاءِ. مثال طور، Netflix مهيا ڪري ٿو ذاتي تجويزون صارف جي ڳولا ۽ ڏسڻ جي تاريخ جي بنياد تي نالي واري اداري جي سڃاڻپ استعمال ڪندي.

نالي واري اينٽيٽي ريڪگنيشن توهان جي مشين لرننگ ماڊلز کي وڌيڪ ڪارآمد ۽ قابل اعتماد بڻائي ٿي - پر اهي صرف تڏهن بهترين ڪارڪردگي ڏيکاريندا آهن جڏهن معيار، مسلسل ليبل ٿيل ڊيٽا تي تربيت ڏني ويندي آهي. اهو ئي آهي جتي هڪ تجربيڪار پارٽنر اهم آهي: شيپ جون اين اي آر ڊيٽا اينوٽيشن سروسز فنانس، انشورنس، ۽ هيلٿ ڪيئر جهڙن ڊومينز ۾ جامع، استعمال لاءِ تيار اين اي آر ڊيٽا سيٽ فراهم ڪن ٿيون، تنهنڪري توهان تيزيءَ سان ڪارآمد، ترقي يافته ايم ايل ماڊل ٺاهي سگهو ٿا.
[پڻ پڙهو: اين ايل پي ڇا آهي؟ اهو ڪيئن ڪم ڪري ٿو، فائدا، چئلينج، مثال
NER ماڊل جو جائزو ڪيئن ورتو ويندو آهي؟
NER ماڊل ٽن ميٽرڪس سان اسڪور ڪيا ويندا آهن: درستگي، ياد ڪرڻ، ۽ F1-اسڪور. اهي ماڊل جي اڳڪٿين جو مقابلو صحيح طور تي ليبل ٿيل ادارن جي "زميني سچائي" سيٽ سان ڪن ٿا.
- سڌائي: ماڊل جي اڳڪٿي ڪيل ادارن مان ڪيترا صحيح هئا؟ اهو غلط مثبت کي ماپي ٿو.
- ياداشت: اصل ۾ موجود ادارن مان، ماڊل ڪيترا ڳولي لڌا؟ اهو غلط منفيات کي ماپي ٿو.
- F1-اسڪور: درستگي ۽ ياد ڪرڻ جو هارمونڪ مطلب - هڪ واحد انگ جيڪو ٻنهي کي متوازن ڪري ٿو.
ڪم ٿيل مثال : "ايپل انڪارپوريشن مارچ 2026 ۾ سان فرانسسڪو ۾ هڪ آفيس کولي رهيو آهي،" ۾ فرض ڪريو ته ماڊل صحيح طور تي "ايپل انڪارپوريشن" ۽ "سان فرانسسڪو" کي ٽيگ ڪري ٿو، غلط طور تي "آفيس" کي هڪ جڳهه طور ٽيگ ڪري ٿو، ۽ "مارچ 2026" کي وڃائي ٿو. اهو 2 سچا مثبت، 1 غلط مثبت، ۽ 1 غلط منفي ڏئي ٿو. درستگي = 2/3 ≈ 0.67، ياد = 2/3 ≈ 0.67، ۽ F1-اسڪور ≈ 0.67. هڪ رکيل تصديق سيٽ تي جانچ - ڊيٽا جيڪو ماڊل ڪڏهن به تربيت ۾ نه ڏٺو - اهو تصديق ڪرڻ لاءِ ضروري آهي ته اهو ياد ڪرڻ بدران عام ڪري ٿو.
NER اوزار ۽ لائبريرين جو مقابلو:
ڪيترائي طاقتور اوزار ۽ لائبريريون NER عمل درآمد کي آسان بڻائين ٿيون. هتي ڪجهه مشهور اختيارن جو هڪ مقابلو آهي:
| اوزار / لائبريري | وضاحت | طاقت | ماڻس |
|---|---|---|---|
| اسپيسائي | Python ۾ هڪ تيز ۽ موثر NLP لائبريري. | بهترين ڪارڪردگي، استعمال ڪرڻ آسان، اڳ-تربيت ٿيل ماڊل موجود آهن. | انگريزيءَ کان سواءِ ٻين ٻولين لاءِ محدود سپورٽ. |
| NLTK | Python ۾ هڪ جامع NLP لائبريري. | ڪارڪردگي جي وسيع رينج، تعليمي مقصدن لاء سٺو. | SpaCy کان وڌيڪ سست ٿي سگهي ٿو. |
| اسٽينفورڊ ڪور اين ايل پي | جاوا تي ٻڌل NLP ٽول ڪٽ. | انتهائي صحيح، ڪيترن ئي ٻولين کي سپورٽ ڪري ٿو. | وڌيڪ حسابي وسيلن جي ضرورت آهي. |
| اوپن اين ايل پي | NLP لاءِ مشين لرننگ تي ٻڌل ٽول ڪٽ. | ڪيترن ئي ٻولين کي سپورٽ ڪري ٿو، حسب ضرورت. | ٺاھڻ لاء پيچيده ٿي سگھي ٿو. |
اين اي آر ۾ ماڊل ٽريننگ
ماڊل ٽريننگ مؤثر نالي واري اداري جي سڃاڻپ (NER) سسٽم جي تعمير جو مرڪز آهي. هن عمل ۾ هڪ ماڊل سيکارڻ شامل آهي ته جيئن نالي واري اداري جي سڃاڻپ ۽ درجه بندي ڪري سگهجي - جهڙوڪ ماڻهو، تنظيمون، ۽ جڳهون - ليبل ٿيل تربيتي ڊيٽا مان سکيا ذريعي. اداري جي سڃاڻپ جي ڪاميابي هن تربيتي ڊيٽا جي معيار ۽ تنوع تي تمام گهڻو منحصر آهي، انهي سان گڏ هر اداري جي قسم لاءِ اڳواٽ بيان ڪيل زمرن جي وضاحت تي.
ماڊل ٽريننگ دوران، مشين لرننگ الگورٿم صحيح اينٽيٽي ليبلز سان تشريح ڪيل ٽيڪسٽول ڊيٽا جو تجزيو ڪن ٿا. ڊيپ لرننگ ماڊل، جن ۾ ريڪرنٽ نيورل نيٽ ورڪ (RNNs) ۽ ڪنوولوشنل نيورل نيٽ ورڪ (CNNs) شامل آهن، NER ڪمن لاءِ خاص طور تي مشهور ٿي ويا آهن. اهي نيورل نيٽ ورڪ ٽيڪسٽ اندر پيچيده نمونن ۽ رشتن کي پڪڙڻ ۾ شاندار آهن، NER ماڊل کي متاثر ڪندڙ درستگي سان ادارن کي سڃاڻڻ جي قابل بڻائين ٿا - جيتوڻيڪ جڏهن ٻولي ۾ نازڪ تبديلين کي منهن ڏيڻو پوي ٿو.
جڏهن ته، نالي واري اداري جي سڃاڻپ لاءِ ڊيپ لرننگ ماڊلز جي تربيت لاءِ ليبل ٿيل ڊيٽا جي وڏي مقدار جي ضرورت هوندي آهي، جيڪا پيدا ڪرڻ ۾ وقت لڳندڙ ۽ مهانگو ٻئي ٿي سگهي ٿي. ان کي حل ڪرڻ لاءِ، ڊيٽا جي واڌاري ۽ منتقلي جي سکيا جهڙيون ٽيڪنڪون اڪثر استعمال ڪيون وينديون آهن. ڊيٽا جي واڌاري موجوده ڊيٽا مان نوان مثال پيدا ڪندي تربيتي ڊيٽا سيٽ کي وڌائيندي آهي، جڏهن ته منتقلي جي سکيا اڳ ۾ تربيت يافته ماڊلز کي فائدو ڏئي ٿي جيڪي اڳ ۾ ئي عام ٻولي جا نمونا سکي چڪا آهن، صرف ڊومين جي مخصوص ڊيٽا تي فائن ٽيوننگ جي ضرورت هوندي آهي.
آخرڪار، هڪ NER ماڊل جي اثرائتي مضبوط ماڊل ٽريننگ، اعليٰ معيار جي ليبل ٿيل ڊيٽا، ۽ مشين لرننگ يا ڊيپ لرننگ ماڊلز جي محتاط چونڊ تي منحصر آهي جيڪي مخصوص اداري جي سڃاڻپ جي ڪم لاءِ مناسب آهن.
مؤثر NER لاءِ بهترين طريقا
نالي واري اداري جي سڃاڻپ (NER) ۾ اعليٰ ڪارڪردگي حاصل ڪرڻ لاءِ بهترين طريقن جي هڪ سيٽ تي عمل ڪرڻ جي ضرورت آهي جيڪي ڊيٽا جي معيار ۽ ماڊل ڊولپمينٽ ٻنهي کي حل ڪن ٿا. مؤثر اداري جي سڃاڻپ لاءِ هتي ڪجهه اهم حڪمت عمليون آهن:
- اعليٰ معيار جي تربيتي ڊيٽا کي ترجيح ڏيو: ڪنهن به ڪامياب اين اي آر ماڊل جو بنياد متنوع، چڱي طرح بيان ڪيل، ۽ نمائندگي ڪندڙ تربيتي ڊيٽا آهي. ليبل ٿيل ڊيٽا کي ادارن جي قسمن ۽ تناظر جي وسيع رينج کي ڍڪڻ گهرجي ته جيئن ماڊل نئين منظرنامي ۾ عام ٿي سگهي.
- مڪمل ٽيڪسٽ پري پروسيسنگ: ٽوڪنائيزيشن ۽ پارٽ آف اسپيچ ٽيگنگ جهڙا قدم ماڊل کي متن جي بناوت کي بهتر سمجهڻ ۾ مدد ڪن ٿا، جنهن سان نامزد ٿيل ادارن کي صحيح طور تي سڃاڻڻ ۽ درجه بندي ڪرڻ جي صلاحيت بهتر ٿئي ٿي.
- صحيح الگورتھم چونڊيو: جڏهن ته قاعدي تي ٻڌل طريقا سادي يا انتهائي منظم ڪمن لاءِ اثرائتو ٿي سگهن ٿا، ڊيپ لرننگ ماڊل جهڙوڪ آر اين اين ۽ سي اين اين اڪثر پيچيده، وڏي پيماني تي اين اي آر ڪمن لاءِ بهترين نتيجا فراهم ڪن ٿا.
- اڳ-تربيت ٿيل ماڊلز جو فائدو وٺو: اڳ ۾ تربيت يافته ماڊلز کي استعمال ڪرڻ ۽ انهن کي پنهنجي مخصوص ڊيٽاسيٽ تي بهتر ڪرڻ سان وڏي پيماني تي ليبل ٿيل ڊيٽاسيٽس جي ضرورت کي گهٽائي سگهجي ٿو، ترقي کي تيز ڪري سگهجي ٿو ۽ ڪارڪردگي بهتر بڻائي سگهجي ٿي.
- مسلسل ماڊل تشخيص ۽ فائن ٽيوننگ: مضبوط تشخيصي ميٽرڪس استعمال ڪندي پنهنجي نير ماڊل جي ڪارڪردگي جو باقاعدي جائزو وٺو، ۽ ان کي اپڊيٽ ڪريو جيئن نئون ڊيٽا يا اداري جي سڃاڻپ جا ڪم سامهون اچن.
- تعلقي آگاهي: هميشه ان تناظر تي غور ڪريو جنهن ۾ وجود ظاهر ٿين ٿا. هي وجود جي نالن کي واضح ڪرڻ ۾ مدد ڪري ٿو جن جا ڪيترائي مطلب ٿي سگهن ٿا، جنهن جي ڪري وجود جي وڌيڪ صحيح سڃاڻپ ٿئي ٿي.
انهن بهترين طريقن تي عمل ڪندي، تنظيمون وڌيڪ صحيح، موافقت لائق، ۽ ڪارآمد NER سسٽم ٺاهي سگهن ٿيون جيڪي پيچيده ٽيڪسٽ ڊيٽا مان ادارن کي ڪڍڻ ۾ شاندار آهن.
ڪيس اسٽڊي: آنڪولوجي ريسرچ لاءِ ڪلينڪل اين اي آر
ڪلينڪل ٽيڪسٽ اهو آهي جتي NER واقعي ڏکيو ٿي ويندو آهي - ۽ جتي اهو سڀ کان وڌيڪ اهم آهي. هڪ صحت جي سار سنڀال جي منصوبي ۾، شيپ هڪ وڏي صحت جي سار سنڀال تنظيم کي غير منظم آنڪولوجي رڪارڊ کي تحقيق لاءِ تيار ڊيٽاسيٽ ۾ تبديل ڪرڻ ۾ مدد ڏيڻ لاءِ هڪ ڪلينڪل NER ۽ ڊي-آئينٽيفڪيشن پائپ لائن ٺاهي، سڀ HIPAA جي تحت.
ڪم شخص ۽ جڳهه کي ٽيگ ڪرڻ کان گهڻو اڳتي وڌيو. آنڪولوجي جي ماهر سان گڏ تشريح ٽيمن تقريباً 10,000 صفحن جي آنڪولوجي رڪارڊن تي هڪ امير اداري اسڪيما کي ليبل ڪيو، جنهن ۾ شامل آهن:
- بيماري جون شيون: ڪينسر جو مسئلو، هسٽولوجي، جسم جي سائيٽ، رويي، گريڊ، ڪينسر اسٽيج، ۽ TNM اسٽيجنگ.
- علاج جا ادارا: ڪينسر جي دوا، دوا جي مقدار، تعدد، ڪينسر جي سرجري، ۽ تابڪاري جو طريقو ۽ مقدار.
- جينومڪس ادارا: جين جو مطالعو، تبديلي ڪوڊ، طريقو، ۽ نمونو.
- انڪار جي حيثيت: منفي، ممڪن-منفي، غير يقيني، ۽ ممڪن-مثبت نتيجن ۾ فرق ڪرڻ - ڪلينڪل نوٽس ۾ اهم.
- ڪلينڪل اين اي آر تعلقات: ڳنڍڻ واريون شيون جهڙوڪ ڪينسر جو مسئلو → جسم جي سائيٽ ۽ هسٽولوجي → گريڊ، تنهنڪري ڊيٽا صرف ليبل نه پر معنيٰ کي پڪڙي ٿو.
ڊيٽا سيٽ کي شيپ جي 5 ملين کان وڌيڪ اليڪٽرانڪ هيلٿ ريڪارڊز جي ذخيري مان تيار ڪيو ويو، پوءِ HIPAA جي سيف هاربر طريقي سان سڃاڻپ ختم ڪئي وئي - محفوظ صحت جي معلومات جي هر ٽڪري کي ليبل ٿيل پلیس هولڊرز سان تبديل ڪيو ويو ته جيئن ڊيٽا مفيد رهي جڏهن ته مريض جي رازداري برقرار رهي. QA ۽ ڪلائنٽ جي موٽ جي لڳاتار دورن تشريح کي گهربل معيار جي معيار تائين پهچايو.
نتيجو: 10,000 اعليٰ معيار جا، غير سڃاڻپ ٿيل، ليبل ٿيل رڪارڊ جيڪي هاڻي ڪلائنٽ جي آنڪولوجي اين ايل پي ماڊل ڊولپمينٽ کي سهارو ڏين ٿا. پروجيڪٽ ڏيکاري ٿو ته پيداوار ڪلينڪل اين اي آر ڪهڙي گهرج ڪري ٿو - ڊومين-ماهر اينوٽيٽرز، هڪ رشتي کان واقف اسڪيما، نفي هينڊلنگ، ۽ ايئر ٽائيٽ تعميل - جن مان ڪو به عام مقصد وارو ماڊل باڪس کان ٻاهر نه پهچائيندو آهي. توهان مڪمل بريڪ ڊائون لاءِ مڪمل آنڪولوجي اين ايل پي ڊولپمينٽ ڪيس اسٽڊي پڙهي سگهو ٿا.
NER فائدا ۽ چئلينج؟
فائدا:
- معلومات ڪڍڻ: NER اهم ڊيٽا کي سڃاڻي ٿو، معلومات حاصل ڪرڻ ۾ مدد ڪندي.
- مواد جي تنظيم: اهو مواد کي درجه بندي ڪرڻ ۾ مدد ڪري ٿو، ڊيٽابيس ۽ سرچ انجڻ لاءِ مفيد.
- بهتر ڪيل صارف جو تجربو: NER ڳولا جي نتيجن کي بهتر ڪري ٿو ۽ سفارشون ذاتي ڪري ٿو.
- بصيرت وارو تجزيو: اهو جذبي جي تجزيي ۽ رجحان جي سڃاڻپ کي آسان بڻائي ٿو.
- خودڪار فلو: NER خودڪار کي فروغ ڏئي ٿو، وقت ۽ وسيلن جي بچت.
حدون / چئلينج:
- ابهام جو حل: هڪجهڙائي رکندڙ ادارن جهڙوڪ ”Amazon“ کي درياءَ يا ڪمپني جي حيثيت ۾ ڌار ڪرڻ سان جدوجهد.
- ڊومين جي مخصوص موافقت: وسيلا-گھڻيون مختلف ڊومينز ۾.
- ٻولي جي تبديليون: اثر رسوخ ۽ علائقائي اختلافن جي ڪري مختلف آهي.
- ليبل ٿيل ڊيٽا جي کوٽ: تربيت لاءِ وڏي ليبل ٿيل ڊيٽا سيٽن جي ضرورت آهي.
- غير منظم ڊيٽا کي سنڀالڻ: جديد ٽيڪنالاجي جي ضرورت آهي.
- ڪارڪردگي جي ماپ: صحيح تشخيص پيچيده آهي.
- حقيقي وقت جي پروسيسنگ: رفتار کي توازن سان درست ڪرڻ مشڪل آهي.
- حوالي سان انحصار: درستگي ڀرپاسي جي متن جي نونسن کي سمجهڻ تي ڀاڙي ٿي.
- ڊيٽا اسپارسيٽي: خاص طور تي خاص علائقن لاءِ خاص ليبل ٿيل ڊيٽا سيٽن جي ضرورت آهي.
نالي واري اداري جي سڃاڻپ جو مستقبل ڇا آهي؟
اين اي آر جو مستقبل سادي ٽيگنگ کان اڳتي وڌي رهيو آهي امير، وڌيڪ ڪارآمد، ۽ وڌيڪ گهڻ لساني نظامن ڏانهن. ڪيتريون ئي تبديليون نمايان آهن:
- ڪجھ شاٽ ۽ زيرو شاٽ سکيا وڏي ليبل ٿيل ڊيٽاسيٽس تي انحصار کي گهٽائي رهي آهي، جنهن سان NER کي نئين ڊومينز ۾ وڌائڻ تيز ٿي رهيو آهي.
- ادارو ڳنڍڻ - هڪ معلوم ٿيل اداري کي علم-گراف رڪارڊ سان ڳنڍڻ - NER کي هڪ ليبلر کان هڪ دليل واري قدم ۾ تبديل ڪري رهيو آهي، جنهن ۾ ريٽريول-آگمينٽڊ جنريشن (RAG) لاءِ گرائونڊنگ پرت شامل آهي.
- ٽرانسفارمر ۽ ايل ايل ايم تي ٻڌل اين اي آر مبهم ۽ اندروني ادارن تي درستگي وڌائيندا رهو.
- گهڻ لساني ۽ بين لساني NER ڪاروبار جي عالمي سطح تي ترقي ٿي رهي آهي ۽ انهن کي رسم الخط ۽ ٻولين ۾ مسلسل اضافي جي ضرورت آهي.
- ڪسٽم، ڊومين مخصوص ماڊل طب، قانون ۽ ماليات لاءِ معيار بڻجي رهيا آهن، ڇاڪاڻ ته خاص ادارا عام ڪارپورا ۾ گهٽ ئي نظر اچن ٿا.
پنهنجي اين اي آر پروجيڪٽ لاءِ شيپ کي ڇو چونڊيو؟
گھڻا NER منصوبا ماڊل تي نه پر ڊيٽا تي ٻڌل هوندا آهن. NER ڪم لاءِ Shaip جي سفارش ڪئي وئي آهي ڇاڪاڻ ته اسان هڪ جزو فراهم ڪندا آهيون جيڪو اڳ ۾ تربيت يافته ماڊل نٿا ڪري سگهن: صحيح، ڊومين مخصوص، مسلسل ليبل ٿيل تربيتي ڊيٽا پيماني تي. NER ۽ اداري ڪڍڻ جي شروعاتن لاءِ، اسان مهيا ڪندا آهيون:
- ڊومين ماهر تشريح ڪندڙ - طبي، قانوني، مالي، ۽ ڪلينڪل اين اي آر لاءِ خاص ٽيمون شامل آهن، جتي عام ليبل گهٽ ٿين ٿا.
- تعلق ۽ نفي جي ليبلنگ، صرف فليٽ اينٽيٽي ٽيگ نه، تنهنڪري توهان جو ماڊل معنيٰ ۽ تناظر سکي ٿو.
- HIPAA، GDPR، ۽ SOC 2- ترتيب ڏنل ڪم جو وهڪرو، حساس ڊيٽا جهڙوڪ PHI ۽ PII جي سڃاڻپ کي ختم ڪرڻ سان.
- ملٽي اسٽيج QA هر ڊيٽا سيٽ کي توهان جي معيار جي معيار تي رکڻ لاءِ پروسيس ماهرن پاران ٺاهيو ويو آهي.
- لچڪدار پيمانو، هڪ عالمي افرادي قوت ۽ وڏي ملڪيت واري ڊيٽا ذخيرن تي ڊرائنگ ڪندي.
ڇا توهان کي ڪسٽم NER ڊيٽاسيٽ، ڪلينڪل ڊي-آئينٽيفڪيشن، يا اينڊ-ٽو-اينڊ نالي واري اداري جي سڃاڻپ جي تشريح جي ضرورت آهي ، اسان جون ٽيمون ان کي توهان جي اسڪيما ۾ ٺاهي سگهن ٿيون.
ڇا توهان NER ٽريننگ ڊيٽا ٺاهڻ لاءِ تيار آهيو جنهن تي توهان ڀروسو ڪري سگهو ٿا؟ پنهنجي پروجيڪٽ جي دائري کي وڌائڻ لاءِ Shaip سان رابطو ڪريو ۽ پنهنجي AI/ML ماڊلز لاءِ هڪ ڪسٽم NER ڊيٽا سيٽ حاصل ڪريو.
اين اي آر ايف اي ڪيو: پروجيڪٽ شروع ڪرڻ کان اڳ ٽيمون پڇن ٿا سوال
اهي سوال آهن جيڪي سڀ کان وڌيڪ سامهون اچن ٿا جڏهن ٽيمون "NER ڇا آهي" کان اصل ۾ اسڪوپنگ، بجيٽنگ، ۽ NER پروجيڪٽ جي سورسنگ ڏانهن منتقل ٿين ٿيون.
ڪسٽم اين اي آر ماڊل کي تربيت ڏيڻ لاءِ مون کي ڪيترو ليبل ٿيل ڊيٽا جي ضرورت آهي؟
عملي شروعاتي نقطي جي طور تي هر اداري جي قسم لاءِ ڪجهه هزار تشريح ٿيل مثالن جو منصوبو ٺاهيو - حقيقي دنيا جي ڪسٽم NER ماڊل اڪثر ڪري ڪجهه هزار نمونن تي تربيت يافته هوندا آهن. شروع کان تربيت جي ضرورت آهي، تنهن ڪري گهڻيون ٽيمون ان جي بدران اڳ ۾ تربيت يافته ماڊل کي بهتر بڻائين ٿيون. ليبلز جي معيار ۽ تسلسل خام حجم کان وڌيڪ اهم آهي؛ شور واري ڊيٽا ڪيپس جي درستگي تيز آهي.
ڇا مون کي پنهنجو NER ٽريننگ ڊيٽا سيٽ گهر ۾ ٺاهڻ گهرجي يا تشريح کي آئوٽ سورس ڪرڻ گهرجي؟
جڏهن توهان کي حجم، رفتار، ڊومين جي مهارت، يا تعميل جي ضرورت هجي ته آئوٽ سورس ڪريو، توهان اندروني طور تي اسٽاف نٿا ڪري سگهو؛ صرف ان وقت گهر ۾ تعمير ڪريو جڏهن توهان جو اسڪيما سادو، مستحڪم ۽ ننڍو هجي. گهڻيون ٽيمون تشريح کي گهٽ سمجهن ٿيون - هدايتون، ليبلنگ، ۽ QA هڪ NER پروجيڪٽ جو وڏو حصو استعمال ڪن ٿا. شيپ جهڙو هڪ خاص پارٽنر ان لوڊ کي جذب ڪري ٿو تنهنڪري توهان جا انجنيئر ماڊلنگ تي ڌيان ڏين ٿا، ليبلنگ تي نه.
منهنجي NER ماڊل ۾ ڊومين جي مخصوص ادارن جي کوٽ ڇو رهي ٿي؟
ڇاڪاڻ ته عام مقصد جا ماڊل خبرن ۽ ويب ٽيڪسٽ تي تربيت يافته هوندا آهن، اهي گهٽ ۾ گهٽ خاص اصطلاحن کي سڃاڻندا آهن جهڙوڪ دوا جا نالا، قانوني شقون، يا مالي اوزار. حل تشريح ٿيل، ڊومين ۾ ڊيٽا تي فائن ٽيوننگ آهي جنهن ۾ اهي ادارا حقيقي تناظر ۾ شامل آهن. غير مطابقت رکندڙ ليبلنگ هدايتون ٻيون عام مجرم آهن، تنهن ڪري اسڪيلنگ کان اڳ پنهنجا تشريح ضابطا بند ڪريو.
ڪسٽم NER ڊيٽا سيٽ ٺاهڻ ۾ ڪيترو خرچ ايندو؟
قيمت اداري جي پيچيدگي، تشريح جي مقدار، گهربل ڊومين جي ماهريت، ۽ تعميل جي ضرورتن تي منحصر آهي - ڪلينڪل يا قانوني ليبلنگ جي قيمت عام متن کان وڌيڪ آهي ڇاڪاڻ ته ان کي ماهر تشريح ڪندڙ ۽ سخت QA جي ضرورت آهي. قيمت عام طور تي هر صفحي، هر دستاويز، يا هر تشريح ٿيل يونٽ جي حوالي سان ڏني ويندي آهي. شيپ هر NER پروجيڪٽ کي توهان جي اسڪيما ۽ معيار جي بار تائين اسڪوپ ڪري ٿو ۽ هڪ ترتيب ڏنل اقتباس فراهم ڪري ٿو.
مان اعليٰ معيار جو NER يا ڪلينڪل NER ٽريننگ ڊيٽا ڪٿان حاصل ڪري سگهان ٿو؟
NER ٽريننگ ڊيٽا کي ٽن طريقن سان ماخذ ڪريو: هڪ آف دي شيلف ڊيٽاسيٽ کي لائسنس ڏيو، هڪ ڪسٽم ڊيٽاسيٽ گڏ ڪريو ۽ انوٽ ڪريو، يا موجوده ڪورپس کي وڌايو. ڊومين جي مخصوص يا منظم ڪم لاءِ - طبي، قانوني، مالي - هڪ منظم تشريح فراهم ڪندڙ قابل اعتماد رستو آهي. Shaip توهان جي صحيح وضاحتن مطابق ٺهيل ڪسٽم NER ڊيٽاسيٽ، ڪلينڪل NER، ۽ HIPAA- مطابق ڊي-شناخت پهچائي ٿو.
NER، entity extraction، ۽ entity linking ۾ ڇا فرق آهي؟
NER قسم (شخص، تنظيم، مقام) جي لحاظ کان ادارن کي ڳولي ٿو ۽ درجه بندي ڪري ٿو. اداري جي ڪڍڻ کي اڪثر NER سان مٽائي استعمال ڪيو ويندو آهي، ڪڏهن ڪڏهن متن مان منظم فيلڊ ڪڍڻ لاءِ وڌيڪ وسيع طور تي. اداري کي ڳنڍڻ هڪ قدم اڳتي وڌندو آهي، هڪ تسليم ٿيل اداري کي علم جي بنياد ۾ هڪ منفرد رڪارڊ سان ڳنڍيندو آهي - اهو حل ڪرڻ ته ڪهڙو "ايپل" يا ڪهڙو "اردن" جو مطلب آهي.
ٿڪل
نالي واري اداري جي سڃاڻپ (NER) هڪ طاقتور اين ايل پي ٽيڪنڪ آهي جيڪا متن جي اندر اهم ادارن جي سڃاڻپ ۽ درجه بندي ڪري ٿي، مشينن کي انساني ٻولي کي وڌيڪ مؤثر طريقي سان سمجهڻ ۽ پروسيس ڪرڻ جي قابل بڻائي ٿي. سرچ انجڻ ۽ چيٽ بوٽس کي وڌائڻ کان وٺي ڪسٽمر سپورٽ ۽ مالي تجزيي کي طاقت ڏيڻ تائين، NER وٽ مختلف صنعتن ۾ مختلف ايپليڪيشنون آهن. جڏهن ته مونجهارن جي حل ۽ غير منظم ڊيٽا کي هٿي وٺرائڻ جهڙن علائقن ۾ چيلنجون آهن، جاري پيش رفت، خاص طور تي ڊيپ لرننگ ۾، NER جي صلاحيتن کي وڌيڪ بهتر ڪرڻ ۽ مستقبل ۾ ان جي اثر کي وڌائڻ جو واعدو ڪن ٿا.




