سافٽ ويئر ڊولپمينٽ وانگر جيڪو ڪوڊ تي ڪم ڪري ٿو، ڪم ڪندڙ مصنوعي ذهانت ۽ مشين لرننگ ماڊلز کي ترقي ڪرڻ لاءِ اعليٰ معيار جي ڊيٽا جي ضرورت آهي. ماڊلز کي پيداوار جي ڪيترن ئي مرحلن تي صحيح طور تي ليبل ٿيل ۽ تشريح ٿيل ڊيٽا جي ضرورت هوندي آهي ڇاڪاڻ ته الگورتھم کي ڪم ڪرڻ لاءِ مسلسل تربيت ڏيڻ جي ضرورت هوندي آهي.
پر، معياري ڊيٽا حاصل ڪرڻ مشڪل آهي. ڪڏهن ڪڏهن، ڊيٽا سيٽ غلطين سان ڀريل هوندا آهن جيڪي منصوبي جي نتيجي تي اثر انداز ٿي سگهن ٿا. ڊيٽا سائنس جا ماهر پهريان توهان کي ٻڌائيندا ته اهي ڊيٽا جي تشخيص ۽ تجزيو ڪرڻ کان وڌيڪ وقت صاف ڪرڻ ۽ اسڪرب ڪرڻ ۾ گذاريندا آهن.
پهرين جڳهه ۾ ڊيٽا سيٽ ۾ موجود غلطيون ڇو آهن؟
صحيح تربيتي ڊيٽا سيٽن جو هجڻ ضروري ڇو آهي؟
AI ٽريننگ ڊيٽا غلطين جا ڪهڙا قسم آهن ؟ ۽، انهن کان ڪيئن بچجي؟
اچو ته ڪجهه انگن اکرن سان شروع ڪريون.
ايم آءِ ٽي ڪمپيوٽر سائنس ۽ آرٽيفيشل انٽيليجنس ليب ۾ محققن جي هڪ گروپ ڏهه وڏن ڊيٽاسيٽس جي ڇنڊڇاڻ ڪئي جن کي 100,000 کان وڌيڪ ڀيرا حوالو ڏنو ويو آهي. محققن اهو معلوم ڪيو ته سڀني تجزيي ڪيل ڊيٽاسيٽس ۾ سراسري غلطي جي شرح تقريبن 3.4٪ هئي . اهو پڻ معلوم ٿيو ته ڊيٽاسيٽس مختلف قسمن جي غلطين جو شڪار ٿيا ، جهڙوڪ تصويرن، آڊيو ۽ ٽيڪسٽ جي جذبات جي غلط ليبلنگ.
پهرين جڳهه ۾ ڊيٽا سيٽ ۾ موجود غلطيون ڇو آهن؟
مثال طور، تصور ڪريو توھان جي آفيس اسسٽنٽ کان پڇڻ لاءِ توھان جي سڀني جڳھن جي ڪاروبار بابت مڪمل تفصيل گڏ ڪرڻ ۽ دستي طور انھن کي اسپريڊ شيٽ ۾ داخل ڪريو. هڪ نقطي يا ٻئي تي، هڪ غلطي ٿيندي. پتو غلط ٿي سگھي ٿو، نقل ٿي سگھي ٿو، يا ڊيٽا جي ميلاپ ٿي سگھي ٿي.
ڊيٽا ۾ غلطيون پڻ ٿي سگھي ٿي جيڪڏھن سينسر پاران گڏ ڪيل سامان جي ناڪامي، سينسر جي خراب ٿيڻ، يا مرمت جي ڪري.
صحيح تربيتي ڊيٽا سيٽن جو هجڻ ضروري ڇو آهي؟
سڀئي مشين لرننگ الگورٿم توهان جي مهيا ڪيل ڊيٽا مان سکندا آهن. ليبل ٿيل ۽ تشريح ٿيل ڊيٽا ماڊلز کي لاڳاپا ڳولڻ، تصورن کي سمجهڻ، فيصلا ڪرڻ ۽ انهن جي ڪارڪردگي جو جائزو وٺڻ ۾ مدد ڪري ٿو. اهو ضروري آهي ته توهان جي مشين لرننگ ماڊل کي غلطي کان پاڪ ڊيٽا سيٽن تي تربيت ڏني وڃي بغير لاڳاپيل خرچن يا تربيت لاءِ گهربل وقت جي باري ۾ پريشان ٿيڻ جي. جيئن ڊگهي عرصي ۾، جيڪو وقت توهان معياري ڊيٽا حاصل ڪرڻ تي خرچ ڪندا آهيو اهو توهان جي AI منصوبن جي نتيجن کي وڌائيندو.
صحيح ڊيٽا تي توهان جي ماڊلز کي تربيت ڏيڻ سان توهان جا ماڊل صحيح اڳڪٿيون ڪري سگهندا ۽ ماڊل جي ڪارڪردگي کي وڌائي سگهندا . استعمال ٿيل معيار، مقدار، ۽ الگورتھم توهان جي AI منصوبي جي ڪاميابي جو تعين ڪندا آهن.
AI ٽريننگ ڊيٽا جي غلطين جا ڪهڙا قسم آهن؟
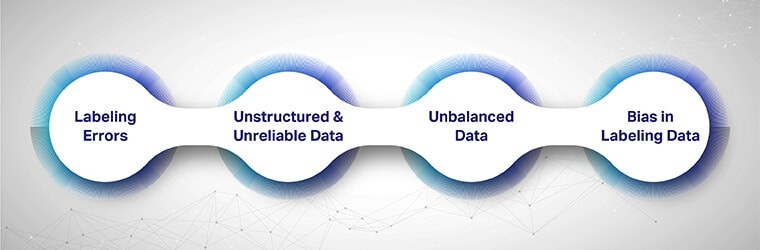
ليبلنگ غلطيون، ناقابل اعتبار ڊيٽا، غير متوازن ڊيٽا، ڊيٽا تعصب
اسان چار سڀ کان وڌيڪ عام ٽريننگ ڊيٽا غلطيون ۽ انهن کان بچڻ جا طريقا ڏسندا.
ليبلنگ غلطيون
ليبلنگ جون غلطيون تربيتي ڊيٽا ۾ ملندڙ سڀ کان عام غلطين مان آهن . جيڪڏهن ماڊل جي ٽيسٽ ڊيٽا ۾ ڊيٽاسيٽس کي غلط ليبل ڪيو ويو آهي، ته نتيجو حل مددگار نه ٿيندو. ڊيٽا سائنسدان ماڊل جي ڪارڪردگي يا معيار بابت صحيح يا بامعني نتيجا نه ڪڍندا.
ليبلنگ غلطيون مختلف شڪلن ۾ اچن ٿيون. اسان نقطي کي اڳتي وڌائڻ لاء هڪ سادي مثال استعمال ڪري رهيا آهيون. جيڪڏهن ڊيٽا اينوٽيٽرز کي تصويرن ۾ هر ٻلي جي چوڌاري بائونڊنگ باڪس ٺاهڻ جو هڪ آسان ڪم آهي، هيٺ ڏنل قسم جي ليبلنگ غلطيون ٿي سگهي ٿي.
- غلط فٽ: ماڊل اوورفٽنگ تڏهن ٿئي ٿو جڏهن بائونڊنگ باڪس اعتراض (ڪٽ) جي ويجهو نه ٺاهيا وڃن، ارادي واري شيءِ جي چوڌاري ڪيترائي خال ڇڏي وڃن.
- غائب ٿيل ليبل: انهي صورت ۾، اينوٽيٽر شايد تصويرن ۾ ٻلي کي ليبل ڪرڻ کان محروم ٿي سگھي ٿو.
- هدايت جي غلط تشريح: بيان ڪندڙن کي مهيا ڪيل هدايتون واضح نه آهن. تصويرن ۾ هر ٻلي جي چوڌاري هڪ بائونڊنگ باڪس رکڻ بدران، اينوٽيٽر هڪ بائونڊنگ باڪس رکي ٿو جنهن ۾ سڀني ٻليون شامل آهن.
- بندش سنڀالڻ: ٻلي جي ڏسڻ واري حصي جي چوڌاري بائونڊنگ باڪس رکڻ جي بدران، بيان ڪندڙ جزوي طور تي نظر ايندڙ ٻلي جي متوقع شڪل جي چوڌاري بائونڊنگ باڪس رکي ٿو.
غير منظم ۽ ناقابل اعتبار ڊيٽا
هڪ ايم ايل پروجيڪٽ جو دائرو انحصار ڪري ٿو ڊيٽا سيٽ جي قسم تي جنهن تي ان کي تربيت ڏني وئي آهي. ڪاروبار کي پنهنجي وسيلن کي استعمال ڪرڻ گهرجي ڊيٽا سيٽ حاصل ڪرڻ لاءِ جيڪي تازه ڪاري، قابل اعتماد ۽ گهربل نتيجا جا نمائندا آهن.
جڏهن توهان ماڊل کي تربيت ڏيو ٿا ڊيٽا تي جيڪو اپڊيٽ نه ڪيو ويو آهي، اهو ٿي سگهي ٿو ايپليڪيشن ۾ ڊگهي مدي واريون حدون. جيڪڏهن توهان پنهنجي ماڊلز کي غير مستحڪم ۽ ناقابل استعمال ڊيٽا تي تربيت ڏيو ٿا، اهو AI ماڊل جي افاديت کي ظاهر ڪندو.
غير متوازن ڊيٽا
ڪنهن به ڊيٽا جي عدم توازن سبب ٿي سگهي ٿي توهان جي ماڊل جي ڪارڪردگي ۾ تعصب. جڏهن اعلي ڪارڪردگي يا پيچيده ماڊل ٺاهي رهيا آهن، تربيتي ڊيٽا جي جوڙجڪ کي احتياط سان غور ڪيو وڃي. ڊيٽا عدم توازن ٻن قسمن جا ٿي سگهن ٿا:
- طبقاتي عدم توازن: طبقاتي عدم توازن تڏهن پيدا ٿئي ٿو جڏهن تربيتي ڊيٽا انتهائي غير متوازن طبقاتي تقسيم آهي. ٻين لفظن ۾، ڪو به نمائندو dataset نه آهي. جڏهن ڊيٽا سيٽن ۾ طبقاتي عدم توازن موجود آهن، اهو حقيقي دنيا جي ايپليڪيشنن سان تعمير ڪرڻ وقت ڪيترائي مسئلا پيدا ڪري سگهي ٿو.
مثال طور، جيڪڏهن الورورٿم کي ٻلين کي سڃاڻڻ جي تربيت ڏني پئي وڃي، ٽريننگ ڊيٽا ۾ صرف ڀتين تي ٻلين جون تصويرون آهن. پوءِ ماڊل سٺي نموني انجام ڏيندو جڏهن ڀتين تي ٻلين جي سڃاڻپ ڪندو پر مختلف حالتن ۾ خراب ڪم ڪندو. - ڊيٽا تازه ڪاري: ڪوبه ماڊل مڪمل طور تي جديد ناهي. سڀ ماڊلز جي زوال پذير آهي، جيئن سچي دنيا ماحول مسلسل تبديل ٿي رهيو آهي. جيڪڏهن ماڊل کي انهن ماحولياتي تبديلين تي باقاعدي اپڊيٽ نه ڪيو وڃي ته ان جي افاديت ۽ قدر گهٽجي ويندا.
مثال طور، تازو تائين، اصطلاح Sputnik لاء هڪ سرسري ڳولا روسي ڪيريئر راڪيٽ بابت نتيجا ڪڍي سگهي ٿي. بهرحال، پوسٽ پنڊيمڪ ڳولا جا نتيجا مڪمل طور تي مختلف هوندا ۽ روسي ڪووڊ ويڪسين سان ڀريل هوندا.
ليبلنگ ڊيٽا ۾ تعصب
ٽريننگ ڊيٽا ۾ تعصب هڪ موضوع آهي جيڪو هاڻي ۽ پوءِ ڪٽجي ٿو. ڊيٽا جي تعصب کي ليبلنگ جي عمل جي دوران يا اينوٽيٽرز طرفان متاثر ٿي سگھي ٿو. ڊيٽا جي تعصب ٿي سگهي ٿي جڏهن اينوٽيٽرز جي هڪ وڏي هيٽروجنيئس ٽيم استعمال ڪندي يا جڏهن ليبلنگ لاءِ هڪ مخصوص حوالي سان گهربل هجي.
تعصب گهٽائڻ ممڪن آهي جڏهن توهان وٽ دنيا جي چوڌاري اينوٽيٽرز هجن يا علائقي جي مخصوص اينوٽيٽرز ڪم ڪن. جيڪڏهن توهان دنيا جي چوڌاري ڊيٽاسيٽ استعمال ڪري رهيا آهيو، ته اهو تمام گهڻو امڪان آهي ته اينوٽيٽرز ليبلنگ ۾ غلطيون ڪن.
مثال طور، جيڪڏهن توهان دنيا جي مختلف کاڌن سان ڪم ڪري رهيا آهيو، برطانيه ۾ هڪ اينوٽيٽر شايد ايشيائي ماڻهن جي خوراڪ جي ترجيحن کان واقف نه هجي. نتيجي ۾ ڊيٽا سيٽ کي انگريزن جي حق ۾ تعصب هوندو.
AI ٽريننگ ڊيٽا جي غلطين کان ڪيئن بچجي؟
ٽريننگ ڊيٽا جي غلطين کان بچڻ جو بهترين طريقو ليبلنگ جي عمل جي هر مرحلي تي سخت معيار جي ڪنٽرول چيڪن کي لاڳو ڪرڻ آهي.
توهان تشريح ڪندڙن کي واضح ۽ صحيح هدايتون فراهم ڪندي ڊيٽا ليبلنگ جي غلطين کان بچي سگهو ٿا. اهو ڊيٽا سيٽ جي هڪجهڙائي ۽ درستگي کي يقيني بڻائي سگهي ٿو.
ڊيٽاسيٽس ۾ عدم توازن کان بچڻ لاءِ، تازو، اپڊيٽ ٿيل، ۽ نمائندگي ڪندڙ ڊيٽاسيٽس حاصل ڪريو. ايم ايل ماڊلز جي تربيت ۽ جانچ کان اڳ پڪ ڪريو ته ڊيٽاسيٽس نوان ۽ غير استعمال ٿيل آهن.
هڪ طاقتور AI منصوبو پنهنجي بهترين ڪارڪردگي لاءِ تازي، غير جانبدار ۽ قابل اعتماد تربيتي ڊيٽا تي ترقي ڪري ٿو. هر ليبلنگ ۽ ٽيسٽنگ اسٽيج تي مختلف معيار جي چڪاس ۽ قدم کڻڻ تمام ضروري آهي. تربيتي غلطيون هڪ اهم مسئلو بڻجي سگهن ٿيون جيڪڏهن انهن کي منصوبي جي نتيجي تي اثر انداز ٿيڻ کان اڳ سڃاڻپ ۽ درست نه ڪيو وڃي.
توهان جي ايم ايل تي ٻڌل پروجيڪٽ لاءِ معياري AI ٽريننگ ڊيٽاسيٽس کي يقيني بڻائڻ جو بهترين طريقو اهو آهي ته هڪ متنوع گروپ جي تشريح ڪندڙن کي نوڪري تي رکيو وڃي جن وٽ پروجيڪٽ لاءِ گهربل ڊومين ڄاڻ ۽ تجربو هجي.
توهان شيپ تي تجربيڪار تشريح ڪندڙن جي ٽيم سان جلدي ڪاميابي حاصل ڪري سگهو ٿا جيڪي مختلف AI تي ٻڌل منصوبن کي ذهين ليبلنگ ۽ تشريح جون خدمتون فراهم ڪن ٿا. اسان کي ڪال ڪريو، ۽ پنهنجي AI منصوبن ۾ معيار ۽ ڪارڪردگي کي يقيني بڻايو.