هڪ ڪامياب مشين لرننگ ماڊل اعليٰ معيار جي تربيتي ڊيٽا سان شروع ٿئي ٿو. پر هڪ عام سوال جيڪو ٽيمون هڪ AI پروجيڪٽ جي شروعات ۾ پڇن ٿيون اهو آهي: ڪيترو تربيتي ڊيٽا ڪافي آهي؟
ايماندار جواب اهو آهي ته هر منصوبي لاءِ ڪو به مقرر تعداد ڪم نٿو ڪري. توهان کي گهربل ڊيٽا جي مقدار ڪم، ماڊل جي پيچيدگي، ڪلاسن جي تعداد، ڊيٽا جي معيار، ليبل جي درستگي، ۽ ڪارڪردگي جي معيار تي منحصر آهي جنهن تائين توهان پهچڻ چاهيو ٿا.
عملي طور تي، تربيتي ڊيٽا جي گهرجن جو اندازو لڳائڻ جو بهترين طريقو اهو آهي ته هڪ نمائندگي واري نموني سان شروع ڪيو وڃي، ترقي پسند طور تي وڏن سب سيٽن تي تربيت ڏني وڃي، ۽ ماپ ڪيو وڃي ته ماڊل جي ڪارڪردگي ڪڏهن برابر ٿيڻ شروع ٿئي ٿي. هي ٽيمن کي قيمت، ٽائم لائن، تشريح جي ڪوشش، ۽ متوقع نتيجن بابت باخبر فيصلا ڪرڻ ۾ مدد ڪري ٿو.
هن بلاگ ۾، اسان مکيه عنصرن کي ٽوڙيو ٿا جيڪي تربيتي ڊيٽا جي مقدار کي متاثر ڪن ٿا، وضاحت ڪريون ٿا ته عملي طور تي گهرجن جو اندازو ڪيئن لڳايو وڃي، ۽ ڏيکاريون ٿا ته جڏهن توهان کي وڌيڪ ڊيٽا جي ضرورت هجي ته توهان جي AI روڊ ميپ کي دير ڪرڻ کان سواءِ ڇا ڪجي.
ٽريننگ ڊيٽا ڇو اهم آهي
تربيتي ڊيٽا هر مشين لرننگ سسٽم جو بنياد آهي. الگورتھم ڪيترو به ترقي يافته هجي، اهو صرف اهي نمونا سکي سگهي ٿو جيڪي ان کي تربيت ڏيڻ لاءِ استعمال ٿيندڙ ڊيٽا ۾ موجود آهن. جيڪڏهن ڊيٽا نامڪمل، جانبدار، شور وارو، يا تمام محدود آهي، ته ماڊل حقيقي دنيا ۾ عام ڪرڻ لاءِ جدوجهد ڪندو.
مضبوط تربيتي ڊيٽا ٽيمن جي مدد ڪري ٿو:
- ماڊل جي درستگي کي بهتر بڻايو
- تعصب ۽ بلائنڊ اسپاٽس کي گھٽايو
- منصوبي جي قيمت ۽ ممڪنيت جو وڌيڪ صحيح اندازو لڳايو
- ماڊل جي ورهاڱي دوران ٻيهر ڪم گھٽايو
- وڌيڪ قابل اعتماد تصديق ۽ جانچ پائپ لائنون ٺاهيو
اهو ئي سبب آهي جو ڊيٽا گڏ ڪرڻ، صفائي، ليبلنگ، ۽ تصديق اڪثر ڪري AI منصوبن ۾ ڪوشش جو سڀ کان وڏو حصو وٺندي آهي. جيڪڏهن ڊيٽا ڪمزور آهي، ته اڳڪٿيون پڻ ڪمزور هونديون.
ڪو به عالمگير انگ ناهي - پر ان جو اندازو لڳائڻ جو هڪ عملي طريقو آهي.
ڪيترائي مضمون هن سوال جو جواب هڪ عدد سان ڏيڻ جي ڪوشش ڪندا آهن. اهو تمام گهٽ مفيد آهي.
سادي بائنري درجي بندي لاءِ هڪ ماڊل نسبتاً ننڍڙي ڊيٽاسيٽ سان سٺو ڪم ڪري سگهي ٿو، جڏهن ته هڪ وڏي ٻولي ماڊل فائن ٽيوننگ ورڪ فلو يا ايج ڪيسن لاءِ ڪمپيوٽر ويزن سسٽم کي خاص طور تي وڌيڪ مثالن جي ضرورت ٿي سگهي ٿي. بهتر سوال اهو ناهي ته "جادو نمبر ڇا آهي؟" پر:
هن استعمال جي ڪيس لاءِ ٽارگيٽ ڪارڪردگي تائين پهچڻ لاءِ گهٽ ۾ گهٽ اعليٰ معيار جي، نمائندگي ڪندڙ تربيتي ڊيٽا جي ڪهڙي مقدار جي ضرورت آهي؟
ان جو جواب ڏيڻ جو هڪ عملي طريقو سکيا جي وکر کي استعمال ڪرڻ آهي: ماڊل کي ڊيٽا جي وڌندڙ مقدار تي تربيت ڏيو ۽ ڏسو ته هر قدم سان ڪارڪردگي ڪيتري بهتر ٿئي ٿي. جڏهن بهتري گهٽجڻ شروع ٿئي ٿي، ته توهان وٽ هڪ واضح سگنل هوندو آهي ته ڇا وڌيڪ ڊيٽا گڏ ڪرڻ سيڙپڪاري جي لائق آهي. هي طريقو عام طور تي عملي ايم ايل ورڪ فلوز ۾ سفارش ڪئي ويندي آهي.
7 عنصر جيڪي طئي ڪن ٿا ته توهان کي ڪيتري تربيتي ڊيٽا جي ضرورت آهي
1. ماڊل جو قسم: ڪلاسيڪل ايم ايل بمقابله ڊيپ لرننگ
ماڊل جي قسم جو ڊيٽا جي گهرجن تي وڏو اثر پوي ٿو. ڪلاسيڪل مشين لرننگ ماڊل جهڙوڪ لاجسٽڪ ريگريشن، فيصلي جا وڻ، يا گريڊينٽ بوسٽنگ اڪثر ڪري ننڍن منظم ڊيٽاسيٽس تي سٺو ڪم ڪري سگهن ٿا، خاص طور تي جڏهن خاصيتون چڱي طرح انجنيئر ٿيل هجن.
ڊيپ لرننگ ماڊلز کي عام طور تي وڌيڪ ڊيٽا جي ضرورت هوندي آهي ڇاڪاڻ ته اهي خاصيتون خودڪار طريقي سان سکندا آهن ۽ انهن ۾ ڪيترائي وڌيڪ پيرا ميٽر هوندا آهن. تصوير، آڊيو، ۽ ٻولي جي ڪمن لاءِ، ڊيپ ماڊلز عام طور تي اضافي ڊيٽا جي مقدار ۽ تنوع مان خاص طور تي فائدو حاصل ڪندا آهن.
2. نگراني ڪيل بمقابله غير نگراني ڪيل سکيا
نگراني ڪيل سکيا لاءِ ليبل ٿيل ڊيٽا جي ضرورت هوندي آهي، جيڪو گڏ ڪرڻ اڪثر ڏکيو ۽ مهانگو هوندو آهي. جيڪڏهن توهان جي ماڊل کي تصويرن جي تشريح ڪرڻ، آڊيو کي نقل ڪرڻ، ادارن کي ٽيگ ڪرڻ، يا دستاويزن جي درجه بندي ڪرڻ لاءِ انسانن جي ضرورت هوندي آهي، ته ڊيٽا جي گهرج کي مقدار ۽ ليبلنگ جي ڪوشش ٻنهي جو حساب رکڻ گهرجي.
غير نگراني ٿيل سکيا لاءِ ليبل ٿيل ڊيٽا جي ضرورت ناهي، پر اهو اڃا تائين وڏي، نمائندگي ڪندڙ ڊيٽاسيٽس مان فائدو حاصل ڪري ٿو. ليبل کان سواءِ به، ماڊل کي بامعني نمونن ۽ بناوت کي ڳولڻ لاءِ ڪافي ڪوريج جي ضرورت آهي.
3. ڪم جي پيچيدگي ۽ ڪلاسن جو تعداد
هڪ سادو بائنري درجي بندي جو ڪم هڪ گھڻ-ڪلاس ميڊيڪل اميجنگ مسئلي يا هڪ گهڻ-ٻولي تقرير جي سڃاڻپ واري نظام کان تمام مختلف آهي.
جيئن ڪم جي پيچيدگي وڌي ٿي، تربيتي ڊيٽا جون گهرجون عام طور تي وڌي وڃن ٿيون ڇاڪاڻ ته ماڊل کي سکڻ گهرجي:
- وڌيڪ ڪلاس
- زمرن جي وچ ۾ بهتر فرق
- وڌيڪ ايج ڪيسز
- وڌيڪ تناظري تبديلي
مثال طور، "ٻلي" ۽ "ڪتي" ۾ فرق ڪرڻ، روشني جي حالتن، ڪئميرا جي زاوين، ۽ پس منظر ۾ ڪيترن ئي بصري طور تي هڪجهڙا پراڊڪٽ نقصن جي سڃاڻپ ڪرڻ کان تمام آسان آهي.
4. ڊيٽا جي معيار ۽ ليبل جي درستگي
جيڪڏهن معيار خراب آهي ته وڌيڪ ڊيٽا هميشه بهتر ناهي.
صحيح ليبلز، متوازن نمائندگي، ۽ مسلسل فارميٽنگ سان هڪ ننڍو ڊيٽاسيٽ هڪ وڏي پر شور واري ڊيٽاسيٽ کي بهتر بڻائي سگهي ٿو. گهٽ معيار جا ليبل، نقل رڪارڊ، ڪمزور ڪلاس وصفون، غائب ميٽا ڊيٽا، ۽ غير مطابقت رکندڙ تشريح هدايتون سڀ ماڊل جي ڪارڪردگي کي گهٽائين ٿيون.
وڌيڪ ڊيٽا گڏ ڪرڻ کان اڳ، ٽيمن کي پڇڻ گهرجي:
- ڇا ليبل هڪجهڙا آهن؟
- ڇا اسان سڀني اهم صارف منظرنامي کي ڍڪي رهيا آهيون؟
- ڇا ڊيٽا پيداوار جي حالتن جي نمائندگي ڪري ٿو؟
- ڇا ٽرين، تصديق، ۽ ٽيسٽ سيٽ صحيح طرح سان الڳ ٿيل آهن؟
ڪيترن ئي منصوبن لاءِ، ڊيٽا جي معيار کي بهتر بڻائڻ صرف ڊيٽا جي مقدار کي وڌائڻ جي ڀيٽ ۾ تيز فائدا پيدا ڪري ٿو.
5. تنوع، ڪوريج، ۽ ڪلاس بيلنس
هڪ ماڊل کي حقيقي دنيا جي تبديلي مان سکڻ گهرجي جيڪا ان کي تعیناتي کان پوءِ منهن ڏيڻو پوندو. ان جو مطلب آهي ته ڊيٽا سيٽ کي مختلف منظرنامي، صارف گروپ، ڊوائيس جي قسمن، تلفظ، ماحول، دستاويز جي فارميٽ، تصوير جي حالتن، ۽ ايج ڪيسز کي ظاهر ڪرڻ گهرجي.
جيڪڏهن هڪ طبقي يا حصي کي گهٽ نمائندگي ڏني وڃي ٿي، ته ماڊل مجموعي طور تي صحيح نظر اچي سگهي ٿو جڏهن ته نازڪ ذيلي گروپن تي خراب طور تي ناڪام ٿي سگهي ٿو. اهو ئي سبب آهي ته تنوع ۽ طبقاتي توازن خام سائيز جيتري ئي اهميت رکي ٿو.
ڪيترين ئي صورتن ۾، سوال اهو ناهي ته "ڇا اسان وٽ ڪافي ڊيٽا آهي؟" پر "ڇا اسان وٽ صحيح ڊيٽا ڪافي آهي؟"
6. سکيا ۽ اڳ-تربيت يافته ماڊلز جي منتقلي
جيڪڏهن توهان اڳ ۾ تربيت يافته ماڊل کان شروعات ڪري رهيا آهيو، ته توهان کي شروعات کان تربيت حاصل ڪرڻ جي ڀيٽ ۾ تمام گهٽ ڪم جي مخصوص ڊيٽا جي ضرورت پوندي.
هي خاص طور تي انهن لاءِ صحيح آهي:
- بصارت جي بنيادي ڪنارن کي استعمال ڪندي تصوير جي درجه بندي
- ٽرانسفارمر تي ٻڌل ماڊل استعمال ڪندي اين ايل پي جا ڪم
- تقرير جا ماڊل جيڪي نئين لهجي يا ڊومين سان مطابقت رکن ٿا
- ڊومين موافقت وارو ڪم فلو
منتقلي سکيا ٽيمن کي وڏي موجوده ڊيٽاسيٽس تي سکيا ڪيل علم کي ٻيهر استعمال ڪرڻ جي اجازت ڏئي ٿي، جيڪو ڊرامائي طور تي تشريح جي بار کي گهٽائي سگهي ٿو. اصل مضمون اڳ ۾ ئي هن کي چڱي طرح ڍڪي چڪو آهي؛ اهو رهڻ گهرجي، پر واضح مثالن سان.
7. تصديق جي حڪمت عملي ۽ ٽارگيٽ ڪارڪردگي
توهان کي گهربل ڊيٽا جي مقدار پڻ ماڊل جي سٺي هجڻ جي ضرورت تي منحصر آهي.
هڪ پروٽوٽائپ شايد معمولي مقدار ۾ ڊيٽا سان ڪم ڪري سگهي ٿو. صحت جي سار سنڀال، فنانس، انشورنس، آٽوميٽو، يا تعميل وارين ماحول ۾ هڪ پيداوار ماڊل کي مضبوط ڪوريج، صاف ليبل، بهتر تصديق، ۽ ڪنڊ ڪيسن ۾ وڌيڪ قابل اعتماد ڪارڪردگي جي ضرورت هوندي. قابل قبول غلطي جي شرح جيتري سخت هوندي، توهان جو ڊيٽا سيٽ اوترو ئي مضبوط هوندو.
عملي طور تي تربيتي ڊيٽا جي گهرجن جو اندازو ڪيئن لڳايو وڃي
اندازو لڳائڻ بدران، هڪ منظم اندازي جي عمل کي استعمال ڪريو.
قدم 1: هڪ نمائندي پائلٽ ڊيٽا سيٽ سان شروع ڪريو
مسئلي واري جاءِ جو هڪ ننڍڙو پر نمائندگي ڪندڙ نمونو گڏ ڪريو. اهم ڪلاس، فارميٽ، استعمال ڪندڙ جا قسم، ۽ حقيقي دنيا جي تبديليون شامل ڪريو.
قدم 2: ڊيٽا کي صحيح طرح ورهايو
الڳ الڳ تربيت، تصديق، ۽ ٽيسٽ سيٽ ٺاهيو. پڪ ڪريو ته ٽيسٽ سيٽ پيداوار جي حالتن کي ظاهر ڪري ٿو ۽ تربيت دوران ڪڏهن به استعمال نه ڪيو وڃي.
قدم 3: ترقي پسند وڏن نمونن تي تربيت ڏيو
ڊيٽاسيٽ جي وڌندڙ حصن کي استعمال ڪندي ماڊل کي تربيت ڏيو، جهڙوڪ 10٪، 20٪، 40٪، 60٪، 80٪، ۽ 100٪.
قدم 4: سکيا جو هڪ وکر ٺاهيو
ڊيٽا سيٽ جي سائيز وڌڻ سان ڪارڪردگي جي ميٽرڪس جهڙوڪ درستگي، F1 اسڪور، ياد ڪرڻ، درستگي، يا ڪم جي مخصوص معيار جي ماپن کي ٽريڪ ڪريو.
قدم 5: پليٽو ڳوليو
جيڪڏهن ماڊل جي ڪارڪردگي وڌيڪ ڊيٽا سان تيزيءَ سان بهتر ٿئي ٿي، ته پوءِ توهان کي شايد وڌيڪ جي ضرورت پوندي. جيڪڏهن بهتري گهٽجي وڃي ٿي، ته پوءِ توهان جو رڪاوٽ هاڻي حجم نه هوندو - اهو ليبل معيار، فيچر ڊيزائن، ماڊل جي چونڊ، يا ڪلاس عدم توازن ٿي سگهي ٿو.
قدم 6: سيگمينٽ-سطح جي ڪارڪردگي جو جائزو وٺو
چيڪ ڪريو ته ماڊل ڪيئن نه رڳو مجموعي طور تي، پر اهم طبقن ۽ ايج ڪيسن ۾ ڪارڪردگي ڏيکاري ٿو. هڪ ماڊل مجموعي طور تي سطح تي ٿي سگهي ٿو جڏهن ته اقليتي طبقن تي اڃا تائين خراب ڪارڪردگي ڏيکاري ٿو. هي طريقو اسٽيڪ هولڊرز کي وڌيڪ حقيقي اندازو ڏئي ٿو ته ڪيترو اضافي ڊيٽا گڏ ڪرڻ جي لائق آهي.
ڪيئن ڄاڻو جڏهن توهان وٽ ڪافي تربيتي ڊيٽا هجي
توهان وٽ شايد ڪافي ڊيٽا هجي جڏهن:
- ماڊل جي ڪارڪردگي صرف ٿوري بهتر ٿئي ٿي جيئن وڌيڪ ڊيٽا شامل ڪيو ويندو آهي
- تصديق جا نتيجا ڪيترن ئي رن يا فولڊز ۾ مستحڪم آهن.
- اهم طبقا قابل قبول ڪارڪردگي ڏيکارين ٿا، صرف اڪثريتي طبقو نه
- ڪارڪردگي هڪ صاف، اڻ ڇهيل ٽيسٽ سيٽ تي قائم آهي.
- باقي غلطيون مثالن جي کوٽ جي ڀيٽ ۾ ليبل شور يا ابهام جي ڪري وڌيڪ ٿين ٿيون.
توهان کي شايد وڌيڪ ڊيٽا جي ضرورت پوندي جڏهن:
- سکيا جو سلسلو اڃا تائين وڌي رهيو آهي.
- ناياب ڪلاس خراب ڪارڪردگي ڏيکارين ٿا.
- ماڊل عام حقيقي دنيا جي مختلف حالتن تي ناڪام ٿئي ٿو.
- نتيجن ۾ ڊوڙن جي وچ ۾ تمام گهڻو اتار چڙهاؤ اچي ٿو.
- تصديق جي ڪارڪردگي جي مقابلي ۾ ٽيسٽ جي ڪارڪردگي تيزي سان گهٽجي ٿي.
ٽريننگ ڊيٽا جي گهرجن کي ڪيئن گھٽائڻ
ڪڏهن ڪڏهن چئلينج ماڊل ڊيزائن نه هوندو آهي - اهو ڊيٽا جي کوٽ، بجيٽ، يا مارڪيٽ ۾ وقت هوندو آهي. انهن حالتن ۾، ٽيمون صحيح حڪمت عملين سان وڏي ڊيٽا جي مقدار تي پنهنجو انحصار گهٽائي سگهن ٿيون.
ڊيٽا جي واڌاري
ڊيٽا جي واڌاري موجوده ڊيٽا مان نوان تربيتي مثال پيدا ڪري ٿي. ڪمپيوٽر جي نظر ۾، ان ۾ ڪٽڻ، گھمڻ، پلٽڻ، يا چمڪ کي ترتيب ڏيڻ شامل ٿي سگھي ٿو. اين ايل پي ۽ تقرير ۾، واڌاري کي وڌيڪ محتاط هجڻ گهرجي، پر ڪنٽرول ٿيل تبديليون اڃا تائين مدد ڪري سگهن ٿيون.
صحيح طريقي سان استعمال ڪرڻ سان، واڌارو مضبوطي کي بهتر بڻائي ٿو ۽ ماڊلز کي بهتر طور تي عام ڪرڻ ۾ مدد ڪري ٿو. خراب استعمال سان، اهو شور يا غير حقيقي مثال متعارف ڪرائي سگهي ٿو.
منتقلي سکيا
منتقلي سکيا توهان کي صفر کان تربيت جي بدران هڪ نئين ڪم لاءِ موجوده ماڊل کي ترتيب ڏيڻ جي اجازت ڏئي ٿي. اهو اڪثر ڪري تربيتي ڊيٽا جي گهرجن کي گهٽائڻ جي سڀ کان اثرائتي طريقن مان هڪ آهي.
اڳ-تربيت ٿيل ماڊلز
اڳواٽ تربيت يافته ماڊل جهڙوڪ BERT جهڙا NLP ماڊل يا قائم ٿيل بصارت جي پٺڀرائي مضبوط شروعاتي نقطا فراهم ڪري سگهن ٿا. شروعات کان سڀ ڪجهه سکڻ جي بدران، ماڊل مفيد اڳوڻي ڄاڻ سان شروع ٿئي ٿو.
فعال سکيا
جيڪڏهن ليبلنگ مهانگي آهي، ته فعال سکيا سڀ کان وڌيڪ معلوماتي مثالن کي ترجيح ڏيڻ ۾ مدد ڪري سگهي ٿي. هي تشريح جي ڪارڪردگي کي بهتر بڻائي ٿو ۽ مفيد ڪارڪردگي تائين پهچڻ لاءِ گهربل ليبلن جو تعداد گهٽائي سگهي ٿو.
مصنوعي ڊيٽا
مصنوعي ڊيٽا تڏهن ڪارآمد ٿي سگهي ٿو جڏهن حقيقي دنيا جو ڊيٽا گهٽ هجي، حساس هجي، يا گڏ ڪرڻ ڏکيو هجي، خاص طور تي صحت جي سار سنڀال، ماليات، خودمختيار نظام، ۽ ايج ڪيس سموليشن جهڙن شعبن ۾. پر ان کي حقيقي، نمائندگي ڪندڙ ڊيٽا کي پورو ڪرڻ گهرجي - انڌي طرح تبديل نه ڪرڻ گهرجي.
گھٽ ۾ گھٽ ڊيٽا سيٽن سان مشين لرننگ منصوبن جا حقيقي دنيا جا مثال
جيتوڻيڪ اهو ناممڪن لڳي ٿو ته ڪجهه امڪاني مشين سکيا منصوبن تي عمل ڪري سگهجي ٿو گهٽ ۾ گهٽ خام مال سان، ڪجهه ڪيس حيران ڪندڙ طور تي سچا آهن. حيران ٿيڻ لاءِ تيار ٿيو.
| ڪابل رپورٽ | صحت جي سار سنڀار | ڪلينڪ آرڪولوجي |
| ڪاگل سروي ظاهر ڪري ٿو ته 70 سيڪڙو کان وڌيڪ مشين لرننگ پروجيڪٽ 10,000 کان گهٽ نمونن سان مڪمل ڪيا ويا. | صرف 500 تصويرن سان، هڪ ايم آئي ٽي ٽيم هڪ ماڊل کي تربيت ڏني جيڪا اکين جي اسڪين مان طبي تصويرن ۾ ذیابيطس نيوروپيپي کي ڳولڻ لاء. | صحت جي سار سنڀار سان مثال جاري رکندي، اسٽينفورڊ يونيورسٽي جي ٽيم صرف 1000 تصويرن سان چمڙي جي ڪينسر کي ڳولڻ لاء هڪ ماڊل تيار ڪرڻ ۾ ڪامياب ٿي. |
تعليم يافته اندازو لڳائڻ
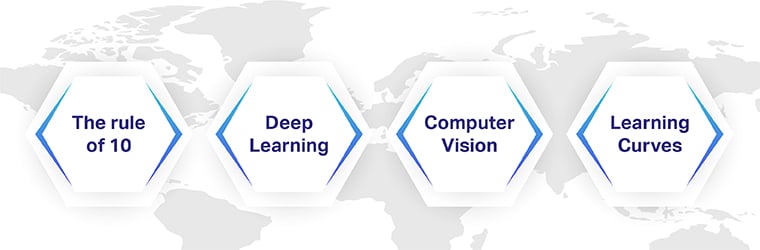
ڊيٽا جي گھٽ ۾ گھٽ مقدار جي حوالي سان ڪو به جادو نمبر نه آھي، پر ڪجھ انگن اکرن جا قاعدا آھن جيڪي توھان استعمال ڪري سگھوٿا ھڪڙي منطقي نمبر تي پھچڻ لاءِ.
10 جو ضابطو
عام اصول جي طور تي ، هڪ ڪارآمد AI ماڊل تيار ڪرڻ لاءِ، گهربل تربيتي ڊيٽا سيٽن جو تعداد هر ماڊل پيرا ميٽر کان ڏهه ڀيرا وڌيڪ هجڻ گهرجي، جنهن کي آزادي جا درجا پڻ چيو ويندو آهي. '10' ڀيرا قاعدن جو مقصد متغير کي محدود ڪرڻ ۽ ڊيٽا جي تنوع کي وڌائڻ آهي. انهي ڪري، هي قاعدو توهان کي گهربل ڊيٽا سيٽن جي مقدار بابت بنيادي خيال ڏئي توهان جي منصوبي کي شروع ڪرڻ ۾ مدد ڪري سگهي ٿو.
گروي سکيا
گہرے سکيا جا طريقا اعليٰ معيار جا ماڊل تيار ڪرڻ ۾ مدد ڪن ٿا جيڪڏهن سسٽم کي وڌيڪ ڊيٽا مهيا ڪئي وڃي. اهو عام طور تي قبول ڪيو ويو آهي ته هر ڪيٽيگري ۾ 5000 ليبل ٿيل تصويرون هجڻ هڪ گہرے سکيا وارو الگورٿم ٺاهڻ لاءِ ڪافي هجڻ گهرجي جيڪا انسانن جي برابر ڪم ڪري سگهي. غير معمولي پيچيده ماڊل کي ترقي ڪرڻ لاء، گهٽ ۾ گهٽ 10 ملين ليبل ٿيل شيون گهربل آهن.
ڪمپيوٽر ويڊيو
جيڪڏهن توهان تصوير جي درجه بندي لاءِ ڊيپ لرننگ استعمال ڪري رهيا آهيو، اتي هڪ اتفاق آهي ته هر ڪلاس لاءِ 1000 ليبل ٿيل تصويرن جو ڊيٽا سيٽ هڪ مناسب نمبر آهي.
سکيا وکر
سکيا وارو وکر استعمال ڪيا ويندا آهن مشين جي سکيا واري الگورتھم ڪارڪردگي کي ظاهر ڪرڻ لاءِ ڊيٽا جي مقدار جي خلاف. Y-axis تي ماڊل مهارت ۽ X-axis تي ٽريننگ ڊيٽا سيٽ ڪرڻ سان، اهو سمجهڻ ممڪن آهي ته ڊيٽا جي سائيز منصوبي جي نتيجن کي ڪيئن متاثر ڪري ٿي.
تمام گهٽ ڊيٽا هجڻ جي قيمت
جڏهن ٽيمون محدود، تنگ، يا جانبدار ڊيٽاسيٽس تي تربيت ڏين ٿيون، ته ماڊل ترقي ۾ اميد افزا نظر اچي سگهي ٿو پر پيداوار ۾ ناڪام ٿي سگهي ٿو.
تمام گهٽ ڊيٽا سبب ٿي سگهي ٿو:
- اوور فٽنگ
- ڪمزور عام ڪرڻ
- غير مستحڪم اڳڪٿيون
- اقليتي طبقن تي خراب ڪارڪردگي
- وڌيڪ تعصب جو خطرو
- وڌيڪ ورهاڱي جو وقت بعد ۾
ٻين لفظن ۾، توهان جي تربيتي ڊيٽا ۾ حدون اڪثر ڪري توهان جي پيداوار جون حدون بڻجي وينديون آهن.
ڇا ڪجي جيڪڏھن توھان کي وڌيڪ ڊيٽا سيٽن جي ضرورت آھي
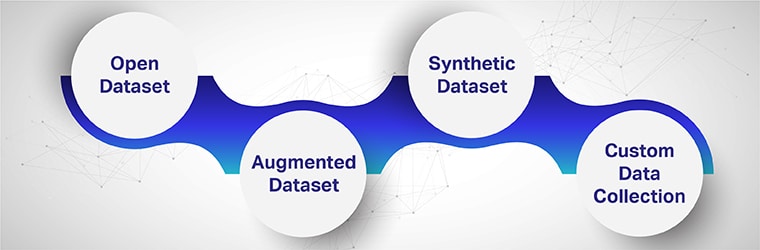
جڏهن توهان ڊيٽا جي فرق جي سڃاڻپ ڪندا آهيو، ته حل هميشه "سڀ ڪجهه گڏ ڪرڻ" ناهي هوندو. هوشيار طريقو اهو آهي ته ڊيٽا سيٽ کي حڪمت عملي طور تي وڌايو وڃي.
1. اوپن ڊيٽاسيٽس کي احتياط سان استعمال ڪريو
کليل ڊيٽا سيٽ پروٽوٽائپنگ يا بينچ مارڪنگ لاءِ مدد ڪري سگھن ٿا، پر اهي هميشه پيداوار جي استعمال لاءِ مناسب نه هوندا آهن. ٽيمن کي انهن تي انحصار ڪرڻ کان اڳ اصل، رضامندي، معيار، مطابقت، ۽ ڪوريج جو جائزو وٺڻ گهرجي.
2. پنهنجي استعمال جي ڪيس لاءِ ڪسٽم ڊيٽا گڏ ڪريو
جيڪڏهن ٽارگيٽ ماحول انتهائي مخصوص آهي، ته پوءِ ڪسٽم ڊيٽا گڏ ڪرڻ اڪثر بهترين آپشن هوندو آهي. اهو خاص طور تي ڊومين-هيوي ورڪ فلوز جهڙوڪ هيلٿ ڪيئر AI، ڪنورسيشنل AI، ڪمپيوٽر ويزن ايج ڪيسز، ۽ گهڻ لساني سسٽم لاءِ صحيح آهي.
3. تشريح ذريعي موجوده ڊيٽا کي بهتر بڻايو
ڪيترين ئي ٽيمن وٽ اڳ ۾ ئي خام ڊيٽا آهي پر انهن ۾ ڍانچي جي کوٽ آهي. تشريح، ري ليبلنگ، ٽيڪسونومي صفائي، ۽ معيار جو جائزو نوان ڊيٽا سيٽ گڏ ڪرڻ کان وڌيڪ تيزيءَ سان قدر کي انلاڪ ڪري سگهن ٿا.
4. گهٽ نمائندگي وارن طبقن کي ٻيهر متوازن ڪريو
جيڪڏهن ڪارڪردگي مخصوص ڪيٽيگريز تي ڪمزور آهي، ته پوءِ پوري ڊيٽا سيٽ کي هڪجهڙائي سان وڌائڻ جي بدران انهن اعليٰ اثر وارن خالن تي گڏ ڪرڻ ۽ ليبلنگ تي ڌيان ڏيو.
5. جتي مناسب هجي مصنوعي يا وڌايل ڊيٽا شامل ڪريو
جڏهن حقيقي ڊيٽا محدود يا حساس هوندو آهي، مصنوعي ۽ وڌايل ڊيٽا ڪوريج کي بهتر بڻائڻ ۾ مدد ڪري سگهي ٿو - پر ان کي حقيقي دنيا جي تقسيم جي خلاف احتياط سان تصديق ڪرڻ گهرجي.
6. هڪ خاص ڊيٽا پارٽنر سان ڪم ڪريو
ٽيمن لاءِ جيڪي پيماني تي پيداوار AI ٺاهي رهيا آهن، هڪ فراهم ڪندڙ سان ڀائيواري ڪرڻ جيڪو اعليٰ معيار جي تربيتي ڊيٽا گڏ ڪري، لائسنس ڏئي، تشريح ڪري، تصديق ڪري ۽ حڪومت ڪري سگهي ٿو، منصوبي جي خطري کي گهٽائي سگهي ٿو ۽ تعیناتي کي تيز ڪري سگهي ٿو.
آخري سوچون
مشين لرننگ ۾ ٽريننگ ڊيٽا لاءِ ڪو به جادوئي انگ ناهي. صحيح مقدار استعمال جي ڪيس، ماڊل جي قسم، ڊيٽا جي معيار، ڪلاس جي تنوع، تصديق جي حڪمت عملي، ۽ ٽارگيٽ ڪارڪردگي تي منحصر آهي.
تربيتي ڊيٽا جي ضرورتن جو اندازو لڳائڻ جو سڀ کان مؤثر طريقو اهو آهي ته هڪ نمائندگي واري نموني سان شروع ڪيو وڃي، سکيا جي وکر استعمال ڪندي ڪارڪردگي کي ماپيو وڃي، ۽ ڊيٽا سيٽ کي حڪمت عملي طور تي وڌايو وڃي جتي ماڊل اڃا تائين ناڪام ٿئي ٿو.
ڪجھ منصوبن لاءِ، هڪ معمولي، اعليٰ معيار جو ڊيٽا سيٽ ڪافي ٿي سگهي ٿو. ٻين لاءِ، خاص طور تي اعليٰ داؤ تي لڳل يا انتهائي متغير ماحول، ڪاميابي جو دارومدار وڏي، احتياط سان ترتيب ڏنل، ۽ چڱي طرح تشريح ڪيل ڊيٽا سيٽن تي هوندو آهي.
سڀ کان وڌيڪ اهم ڳالهه صرف وڌيڪ ڊيٽا هجڻ نه آهي - پر صحيح ڊيٽا هجڻ آهي.
ڇا توهان جي ذهن ۾ ڪو بهترين منصوبو آهي پر توهان پنهنجي ماڊلز کي تربيت ڏيڻ لاءِ تيار ڪيل ڊيٽاسيٽس جي انتظار ۾ آهيو يا توهان پنهنجي منصوبي مان صحيح نتيجو حاصل ڪرڻ لاءِ جدوجهد ڪري رهيا آهيو؟ اسان مختلف قسم جي منصوبي جي ضرورتن لاءِ وسيع تربيتي ڊيٽاسيٽس پيش ڪندا آهيون. اڄ اسان جي ڊيٽا سائنسدانن مان هڪ سان ڳالهائڻ ۽ اهو سمجهڻ سان ته اسان ماضي ۾ گراهڪن لاءِ اعليٰ ڪارڪردگي وارا، معياري ڊيٽاسيٽس ڪيئن پهچائيا آهن، شيپ جي صلاحيت کي استعمال ڪريو.