اي آءِ، بگ ڊيٽا، ۽ مشين لرننگ پاليسي سازن، ڪاروبار، سائنس، ميڊيا هائوسز، ۽ دنيا جي مختلف صنعتن تي اثر انداز ٿي رهيا آهن. رپورٽون ٻڌائين ٿيون ته 2022 ۾ عالمي سطح تي اي آءِ جي اپنائڻ جي شرح هن وقت 35 سيڪڙو تي آهي - 2021 کان 4 سيڪڙو واڌ. رپورٽ موجب 42 سيڪڙو ڪمپنيون پنهنجي ڪاروبار لاءِ اي آءِ جي ڪيترن ئي فائدن کي ڳولي رهيون آهن.
ڪيترن ئي AI شروعاتن ۽ مشين لرننگ حلن کي طاقت ڏيڻ ڊيٽا آهي. AI صرف الگورتھم کي فيڊ ڪرڻ واري ڊيٽا جيترو سٺو ٿي سگهي ٿو. گهٽ معيار وارو ڊيٽا گهٽ معيار جا نتيجا ۽ غلط اڳڪٿيون پيدا ڪري سگهي ٿو.
جڏهن ته ايم ايل ۽ اي آءِ حل جي ترقي تي تمام گهڻو ڌيان ڏنو ويو آهي، پر معيار جي ڊيٽاسيٽ جي طور تي ڇا قابليت رکي ٿو ان جي شعور غائب آهي. هن آرٽيڪل ۾، اسان معياري اي آءِ ٽريننگ ڊيٽا جي ٽائم لائن کي نيويگيٽ ڪريون ٿا ۽ ڊيٽا گڏ ڪرڻ ۽ تربيت جي سمجھ ذريعي اي آءِ جي مستقبل جي سڃاڻپ ڪريون ٿا.
AI ٽريننگ ڊيٽا جي تعريف
جڏهن هڪ ايم ايل حل ٺاهي، مقدار ۽ معيار جي تربيت واري ڊيٽا سيٽ جي اهميت رکي ٿي. ايم ايل سسٽم کي نه رڳو متحرڪ، غير جانبدار، ۽ قيمتي ٽريننگ ڊيٽا جي وڏي مقدار جي ضرورت آهي، پر ان کي پڻ تمام گهڻي ضرورت آهي.
پر AI ٽريننگ ڊيٽا ڇا آهي؟
AI ٽريننگ ڊيٽا ليبل ٿيل ڊيٽا جو هڪ مجموعو آهي جيڪو استعمال ڪيو ويو ML الگورتھم کي تربيت ڏيڻ لاءِ صحيح اڳڪٿيون ڪرڻ لاءِ. ايم ايل سسٽم نمونن کي سڃاڻڻ ۽ سڃاڻڻ جي ڪوشش ڪري ٿو، پيٽرن جي وچ ۾ لاڳاپن کي سمجهڻ، ضروري فيصلا ڪرڻ، ۽ تربيت جي ڊيٽا جي بنياد تي جائزو وٺڻ جي ڪوشش ڪري ٿو.
مثال طور، خود ڊرائيونگ ڪارن جو مثال وٺو. سيلف ڊرائيونگ ايم ايل ماڊل لاءِ ٽريننگ ڊيٽا سيٽ ۾ شامل ٿيڻ گهرجي ليبل ٿيل تصويرون ۽ ڪارن، پيادلن، گهٽين جي نشانين، ۽ ٻين گاڏين جون وڊيوز.
مختصر ۾، ايم ايل الورورٿم جي معيار کي وڌائڻ لاء، توهان کي وڏي مقدار ۾ چڱي طرح ٺهيل، تشريح ٿيل، ۽ ليبل ٿيل ٽريننگ ڊيٽا جي ضرورت آهي.
معيار جي تربيت واري ڊيٽا جي اهميت ۽ ان جو ارتقا
اعليٰ معيار جي تربيت واري ڊيٽا AI ۽ ML ايپ ڊولپمينٽ ۾ اهم ان پٽ آهي. ڊيٽا مختلف ذريعن کان گڏ ڪئي وئي آهي ۽ هڪ غير منظم فارم ۾ پيش ڪيو ويو آهي مشين جي سکيا جي مقصدن لاء غير مناسب. معيار جي تربيت واري ڊيٽا - ليبل ٿيل، نوٽ ڪيل، ۽ ٽيگ ٿيل - هميشه هڪ منظم فارميٽ ۾ آهي - مثالي ايم ايل ٽريننگ لاءِ.
معيار جي تربيت واري ڊيٽا ان کي آسان بڻائي ٿي ML سسٽم لاءِ شيون سڃاڻڻ ۽ انهن کي اڳواٽ مقرر ڪيل خاصيتن جي مطابق درجه بندي ڪرڻ. ڊيٽا سيٽ خراب نموني جا نتيجا پيدا ڪري سگهي ٿي جيڪڏهن درجه بندي درست نه آهي.
AI ٽريننگ ڊيٽا جا شروعاتي ڏينهن
موجوده ڪاروبار ۽ تحقيق جي دنيا ۾ AI جي غلبي جي باوجود، ML جي مصنوعي ذهانت جي غلبي کان اڳ جا شروعاتي ڏينهن بلڪل مختلف هئا.
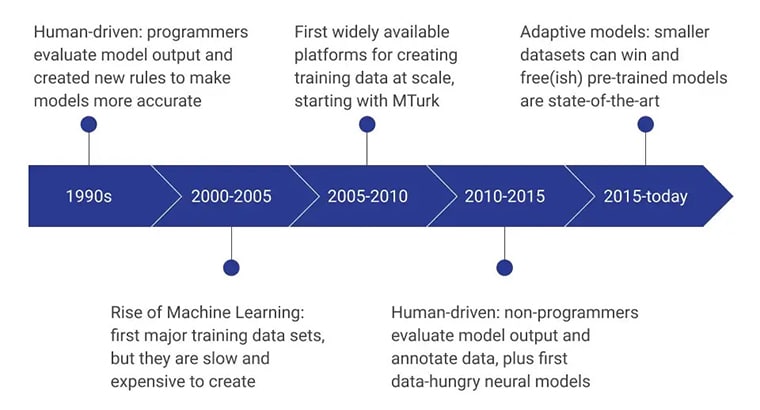
ايندڙ ڪجھ سالن ۾ غير پروگرامرز تي ڌيان ڏنو ويو ڊيٽا ماڊل ٺاهڻ ۽ جائزو وٺڻ. في الحال، توجهه اڳ-تربيت ٿيل ماڊلز تي آهي ترقي يافته تربيتي ڊيٽا گڏ ڪرڻ جا طريقا استعمال ڪندي.
مقدار کان وڌيڪ معيار
جڏهن ڏينهن ۾ AI ٽريننگ ڊيٽاسيٽس جي سالميت جو جائزو ورتو ويو، ڊيٽا سائنسدانن معيار کان وڌيڪ AI ٽريننگ ڊيٽا جي مقدار تي ڌيان ڏنو.
مثال طور، اتي هڪ عام غلط فڪر هو ته وڏي ڊيٽابيس صحيح نتيجا پهچائي. ڊيٽا جي سراسر مقدار کي ڊيٽا جي قيمت جو سٺو اشارو سمجهيو ويندو هو. مقدار صرف هڪ بنيادي عنصرن مان آهي جيڪو ڊيٽا سيٽ جي قيمت کي طئي ڪري ٿو - ڊيٽا جي معيار جو ڪردار تسليم ڪيو ويو.
اهو شعور وڌي ويو ته ڊيٽا جي معيار ڊيٽا جي مڪمل ٿيڻ، اعتبار، صحيحيت، دستيابي، ۽ وقتائتي تي منحصر آهي. سڀ کان اهم ڳالهه اها آهي ته منصوبي لاءِ ڊيٽا جي مناسب هجڻ گڏ ڪيل ڊيٽا جي معيار کي طئي ڪيو.
غريب تربيتي ڊيٽا جي ڪري شروعاتي AI سسٽم جون حدون
غريب تربيتي ڊيٽا، ترقي يافته ڪمپيوٽنگ سسٽم جي کوٽ سان گڏ، شروعاتي AI سسٽم جي ڪيترن ئي ناقص واعدن جي سببن مان هڪ هو.
معيار جي تربيت واري ڊيٽا جي کوٽ جي ڪري، ايم ايل حل صحيح طور تي بصري نمونن جي سڃاڻپ نه ڪري سگهيا جيڪي اعصاب تحقيق جي ترقي کي روڪي رهيا آهن. جيتوڻيڪ ڪيترن ئي محققن ڳالهايل ٻولي جي سڃاڻپ جي واعدي جي نشاندهي ڪئي، تقرير جي سڃاڻپ جي اوزارن جي تحقيق يا ترقي، تقرير جي ڊيٽا سيٽن جي کوٽ جي ڪري ڪامياب نه ٿي سگهي. اعليٰ درجي جي AI اوزارن جي ترقيءَ ۾ هڪ ٻي وڏي رڪاوٽ ڪمپيوٽرن ۾ ڪمپيوٽيشنل ۽ اسٽوريج جي صلاحيتن جي کوٽ هئي.
معيار جي تربيت واري ڊيٽا ڏانهن شفٽ
شعور ۾ هڪ نمايان تبديلي هئي ته ڊيٽا سيٽ جي معيار جو معاملو آهي. ML سسٽم لاءِ انساني ذهانت ۽ فيصلا سازي جي صلاحيتن کي صحيح نموني نقل ڪرڻ لاءِ، ان کي اعليٰ مقدار، اعليٰ معيار جي تربيت واري ڊيٽا تي ترقي ڪرڻي پوندي.
پنهنجي ايم ايل ڊيٽا کي هڪ سروي جي طور تي سوچيو - ڊيٽا نموني جي سائيز جيتري وڏي هوندي، اوتري ئي بهتر اڳڪٿي. جيڪڏهن نموني ڊيٽا ۾ سڀئي متغير شامل نه آهن، ته اهو شايد نمونن کي سڃاڻي نه سگهي يا غلط نتيجا نه آڻي سگهي.
AI ٽيڪنالاجي ۾ ترقي ۽ بهتر تربيتي ڊيٽا جي ضرورت

اهو سمجھڻ ته بهتر ٽريننگ ڊيٽا قابل اعتماد ايم ايل ماڊل جا موقعا وڌائي ٿي بهتر ڊيٽا گڏ ڪرڻ، تشريح، ۽ ليبلنگ طريقن کي جنم ڏنو. ڊيٽا جي معيار ۽ مطابقت سڌو سنئون AI ماڊل جي معيار کي متاثر ڪيو.

ڊيٽا جي معيار ۽ درستگي تي ڌيان وڌايو
ML ماڊل لاءِ صحيح نتيجا مهيا ڪرڻ شروع ڪرڻ لاءِ، ان کي معياري ڊيٽا سيٽن تي فيڊ ڪيو ويندو آهي جيڪي ڊيٽا کي بهتر ڪرڻ واري مرحلي مان گذرن ٿا.
مثال طور، هڪ انسان ڪتي جي مخصوص نسل کي سڃاڻڻ جي قابل ٿي سگھي ٿو ڪجھ ڏينهن اندر ڪتي کي متعارف ڪرائڻ کان پوءِ - تصويرن، وڊيوز، يا ذاتي طور تي. انسان پنهنجي تجربي ۽ لاڳاپيل معلومات مان ڪڍي ٿو ياد رکڻ لاءِ جڏهن ضروري هجي ته هن علم کي ڇڪي. اڃان تائين، اهو هڪ مشين لاء آسانيء سان ڪم نٿو ڪري. مشين کي صاف طور تي بيان ڪيل ۽ ليبل ٿيل تصويرن سان کارائڻو پوندو - سوين يا هزارين - انهي خاص نسل ۽ ٻين نسلن جي ان لاءِ ڪنيڪشن ٺاهڻ لاءِ.
هڪ AI ماڊل تربيت يافته معلومات کي حقيقي دنيا ۾ پيش ڪيل معلومات سان ڳنڍيندي نتيجو جي اڳڪٿي ڪري ٿو . جيڪڏهن تربيتي ڊيٽا ۾ لاڳاپيل معلومات شامل نه هجي ته الگورتھم بيڪار ٿي ويندو آهي.
متنوع ۽ نمائندي ٽريننگ ڊيٽا جي اهميت
هڪ ڊيٽا سيٽ هڪ خاص آبادي، نسل، جنس، پسند، ۽ دانشورانه رايا جي طرف متعصب ٿي سگهي ٿو، جيڪو غلط نموني ڏانهن وٺي سگھي ٿو.
اهو ضروري آهي ته پوري ڊيٽا گڏ ڪرڻ واري عمل جي وهڪري کي يقيني بڻايو وڃي، بشمول موضوع جي پول کي چونڊڻ، ترتيب ڏيڻ، تشريح ۽ ليبلنگ، مناسب طور تي متنوع، متوازن، ۽ آبادي جو نمائندو آهي.

AI ٽريننگ ڊيٽا جو مستقبل
AI ماڊلز جي مستقبل جي ڪاميابي جو دارومدار ML الگورتھم کي تربيت ڏيڻ لاءِ استعمال ٿيندڙ تربيتي ڊيٽا جي معيار ۽ مقدار تي آهي. اهو سمجهڻ ضروري آهي ته ڊيٽا جي معيار ۽ مقدار جي وچ ۾ اهو تعلق ڪم مخصوص آهي ۽ ڪو به قطعي جواب ناهي.
بالآخر، ٽريننگ ڊيٽا سيٽ جي مناسبيت بيان ڪئي وئي آهي ان جي قابليت جي لحاظ سان قابل اعتماد طريقي سان انجام ڏيڻ جي مقصد لاءِ اهو ٺاهيو ويو آهي.
ڊيٽا گڏ ڪرڻ ۽ تشريح جي ٽيڪنالاجي ۾ واڌارو
جيئن ته ML فيڊ ڊيٽا سان حساس آهي، اهو ضروري آهي ته ڊيٽا گڏ ڪرڻ ۽ تشريح جي پاليسين کي منظم ڪرڻ لاء. ڊيٽا گڏ ڪرڻ ۾ غلطيون، ڪرشن، غلط بيان، نامڪمل ماپون، غلط مواد، ڊيٽا جي نقل، ۽ غلط ماپون ڊيٽا جي ناقص معيار ۾ حصو وٺن ٿيون.
ڊيٽا مائننگ، ويب اسڪراپنگ، ۽ ڊيٽا ڪڍڻ جي ذريعي خودڪار ڊيٽا گڏ ڪرڻ تيز رفتار ڊيٽا جي پيداوار لاء رستو ٺاهيندي آهي. اضافي طور تي، اڳ-پيڪيج ٿيل ڊيٽا سيٽس ڪم ڪري ٿو جلدي فيڪس ڊيٽا گڏ ڪرڻ جي ٽيڪنڪ.
ڪرائوڊ سورسنگ ڊيٽا گڏ ڪرڻ جو هڪ ٻيو شاندار طريقو آهي. جڏهن ته ڊيٽا جي سچائي جي تصديق نه ٿي ڪري سگهجي، اهو عوامي تصوير گڏ ڪرڻ لاءِ هڪ بهترين اوزار آهي. آخرڪار، خاص ڊيٽا گڏ ڪرڻ جا ماهر پڻ مخصوص مقصدن لاءِ حاصل ڪيل ڊيٽا فراهم ڪن ٿا.
تربيتي ڊيٽا ۾ اخلاقي خيالن تي زور وڌايو
جيئن ته ڊيٽا ۾ هاڻي هر شيءِ شامل آهي چهري جي تصويرن، آڱرين جي نشانن، آواز جي رڪارڊنگ، ۽ ٻين نازڪ بايو ميٽرڪ ڊيٽا، ان ڪري اهو انتهائي اهم ٿي رهيو آهي ته قانوني ۽ اخلاقي عملن تي عمل ڪرڻ کي يقيني بڻايو وڃي ته جيئن قيمتي مقدمن کان بچڻ ۽ شهرت کي نقصان پهچي.
مستقبل ۾ اڃا به بهتر معيار ۽ متنوع تربيتي ڊيٽا جي صلاحيت
مستقبل ۾ اعليٰ معيار ۽ متنوع تربيتي ڊيٽا لاءِ وڏي صلاحيت آهي . ڊيٽا جي معيار جي آگاهي ۽ ڊيٽا فراهم ڪندڙن جي دستيابي جي مهرباني جيڪي AI حلن جي معيار جي گهرجن کي پورو ڪن ٿا.
موجوده ڊيٽا فراهم ڪندڙ اخلاقي ۽ قانوني طور تي مختلف ڊيٽا سيٽن جي وڏي مقدار کي ماخذ ڪرڻ لاءِ بنيادي ٽيڪنالاجي استعمال ڪرڻ ۾ ماهر آهن. انهن وٽ مختلف ML پروجيڪٽس لاءِ ترتيب ڏنل ڊيٽا کي ليبل ڪرڻ، تشريح ڪرڻ ۽ پيش ڪرڻ لاءِ اندرون ٽيمون پڻ آهن.

ٿڪل
اعليٰ درجي جي AI ماڊلز کي ترقي ڏيڻ لاءِ ڊيٽا ۽ معيار جي تيز سمجھ رکندڙ قابل اعتماد وينڊرز سان ڀائيواري ڪرڻ ضروري آهي . Shaip هڪ اعليٰ تشريح ڪمپني آهي جيڪا ڪسٽمائيز ڊيٽا حل فراهم ڪرڻ ۾ ماهر آهي جيڪي توهان جي AI پروجيڪٽ جي ضرورتن ۽ مقصدن کي پورو ڪن ٿا. اسان سان ڀائيواري ڪريو ۽ اسان جي طرفان پيش ڪيل صلاحيتن، عزم ۽ تعاون کي ڳوليو.