ريئنفورسمينٽ لرننگ (RL) اهو سکڻ ۾ بهترين آهي ته ڇا ڪجي جڏهن انعام جو سگنل صاف هجي ۽ ماحول معاف ڪندڙ هجي. پر ڪيتريون ئي حقيقي دنيا جون سيٽنگون اهڙيون نه آهن. اهي گندا، اعليٰ داؤ تي لڳل آهن، ۽ "تقريبن صحيح" فيصلن سان ڀريل آهن. اهو ئي آهي جتي ماهر-ويٽيڊ استدلال ڊيٽاسيٽ هڪ قوت ضرب بڻجي ويندا آهن: اهي ماڊلز کي هڪ عمل جي پويان ڇو سيکاريندا آهن - صرف نتيجو نه.
آر ايل جي ڪارڪردگي ۾ لڪيل رڪاوٽ: ڪمزور دليل سگنل
آر ايل ايجنٽ تربيت ۾ متاثر ڪندڙ نظر اچن ٿا ۽ اڃا تائين تعیناتي ۾ ناڪام ٿي سگهن ٿا. هڪ عام سبب اهو آهي ته ماڊل شارٽ ڪٽ سکي ٿو - نمونا جيڪي واقف منظرنامي ۾ انعام ڪمائيندا آهن پر جڏهن حالتون تبديل ٿين ٿيون ته ٽٽي پون ٿا.
هتي هڪ ننڍڙي ڪهاڻي آهي جيڪا توهان سڃاڻي سگهندا جيڪڏهن توهان آر ايل سسٽم موڪليا آهن:
هڪ گودام روبوٽڪس ٽيم هڪ ايجنٽ کي شيون چونڊڻ ۽ رکڻ جي تربيت ڏئي ٿي. سموليشن ۾، ڪاميابي جي شرح تيزي سان وڌي ٿي. پر حقيقي منزلن تي، روبوٽ سيٽ اپ کي "گيمنگ" ڪرڻ شروع ڪري ٿو - خطرناڪ ٽريجڪٽريز کي کڻڻ جيڪي سموليٽر ۾ ڪم ڪن ٿا پر عڪاسي ڪندڙ سطحن جي ويجهو ٽڪراءُ جو سبب بڻجن ٿا. انعام جو ڪم غلط نه هو. ماڊل جيڪو دليل سکيو اهو نامڪمل هو.
جڏهن توهان جو ڊيٽا صرف نتيجن کي پڪڙيندو آهي ("ڪاميابي/ناڪامي" يا هڪ اسڪيلر انعام)، توهان وچولي فيصلي جي منطق کي وڃائي ڇڏيندا آهيو جيڪو انسان فطري طور تي استعمال ڪندا آهن: پابنديون، حفاظتي چيڪ، ۽ قدم ترتيب ڏيڻ.
"ماهر جي جانچ ڪيل استدلال جي ڊيٽا" ۾ اصل ۾ ڇا شامل آهي
عملي سطح تي، ماهرن جي جانچ ڪيل استدلال ڊيٽا مثالن جو هڪ ترتيب ڏنل سيٽ آهي جتي ڊومين ماهر فيصلي جي رستي جي تصديق ڪن ٿا - نه رڳو آخري نتيجو.
استدلال جا نشان: غائب وچ
دليل جو نشان مشاهدي → فيصلي → عمل کان قدم بہ قدم رستو آهي. توهان جي استعمال جي صورت تي منحصر ڪري، اهو هن طرح نظر اچي سگهي ٿو:
- لاڳاپيل سگنلن جي سڃاڻپ ("سينسر ڊرفٽ جو پتو لڳايو ويو؛ اعتماد گهٽجي ويو")
- ڊومين قاعدن کي لاڳو ڪرڻ ("داخل ٿيڻ کان اڳ حاصل ڪريو؛ پيادلن کي ترجيح ڏيو")
- پابندين سان عملن جي چونڊ ("انڌي جاءِ کان بچڻ لاءِ رستو B چونڊيو")
"ويٽيڊ" جو مطلب ڇا آهي (سادي انگريزي ۾)
"تصديق ٿيل" ۾ عام طور تي شامل آهن:
- ماهر پاران لکيل يا ماهر جي نظرثاني ٿيل هدايتون
- هڪجهڙائي واري ليبلنگ روبرڪ (ته جيئن ٻه ماهر ساڳئي ڪيس کي ساڳئي طرح حل ڪن)
- تضادن ۽ گم ٿيل قدمن لاءِ منظم جانچ
- هدايتن جي ارتقا سان تبديلين جو هڪ آڊٽ ٽريل
هي معاملو آهي ڇاڪاڻ ته ننڍيون منطقي غلطيون ڪيسڪيڊ ٿي سگهن ٿيون - خاص طور تي جڏهن توهان بعد ۾ انعام جي ماڊلز کي تربيت ڏيو ٿا يا انساني موٽ ڏيڻ وارا لوپ استعمال ڪريو ٿا.
ڪيئن استدلال ڊيٽاسيٽ مضبوط ڪرڻ واري سکيا ماڊل جي ڪارڪردگي کي بهتر بڻائين ٿا
فائدا صوفياتي نه آهن. اهي مشيني آهن.
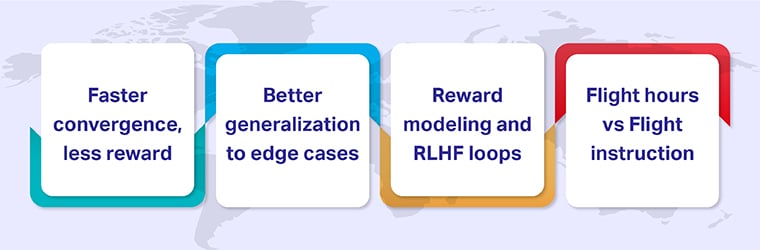
تيز ڪنورجنسي، گهٽ انعام وارو هيڪنگ
دليلن جا نشان ڳولا جي جاءِ کي گھٽائي ڇڏيندا آهن. انڌي طرح ڳولا ڪرڻ جي بدران، ايجنٽ کي منظم سگنل ملندا آهن ته ڪهڙا وچولي قدم صحيح آهن. ان جو عام طور تي مطلب آهي ته گهٽ تربيتي ورهاڱي کي ختم ٿيل سرن تي ضايع ڪيو ويندو آهي ۽ انعام جي فنڪشن جا گهٽ "هوشيار" ڪارناما.
آر ايل ايڇ ايف ۽ انعام ماڊلنگ تي تحقيق بار بار نمايان ڪري ٿي ته تربيت ڪيتري حساس ٿي سگهي ٿي شور يا گهٽ معيار جي ترجيح / موٽ ڊيٽا لاءِ (ذريعو: ايسوسيئيشن فار ڪمپيوٽيشنل لنگوسٽڪس، 2024). اها حساسيت آر ايل ۾ غائب نه ٿيندي آهي - اهو وڌائيندو آهي.
ڪنارن جي ڪيسن لاءِ بهتر عام ڪرڻ
ماهر دليل رڪاوٽن ۽ اصولن کي انڪوڊ ڪري ٿو جيڪي منتقل ڪن ٿا: حفاظتي حدون، تعميل جا قاعدا، ۽ سببي منطق. جڏهن ماحول تبديل ٿئي ٿو، اهي اصول اڃا تائين برقرار رهن ٿا - جيتوڻيڪ صحيح پکسلز، متن، يا رياستي منتقلي نه ڪن.
وڌيڪ مستحڪم انعام ماڊلنگ ۽ RLHF لوپس
جيڪڏهن توهان RLHF طرز جي پوسٽ ٽريننگ استعمال ڪري رهيا آهيو، ته استدلال ڊيٽا توهان کي بهتر انعام جا ماڊل ٺاهڻ ۾ مدد ڪري ٿو - ڇاڪاڻ ته انعام ماڊل نه رڳو "سٺا جواب"، پر "سٺا فيصلي جا رستا" سکور ڪرڻ سکي سگهي ٿو. اهو اصلاح دوران وڌيڪ مسلسل اپڊيٽس ۽ گهٽ رجعت ۾ ترجمو ڪري ٿو جڏهن توهان تربيت کي ماپيو ٿا.
جيڪڏهن توهان RLHF پائپ لائنون ٺاهي رهيا آهيو يا ان کي اسڪيل ڪري رهيا آهيو، ته Shaip جا RLHF حل ماهرن جي اڳواڻي ۾ ڪم جي وهڪري ۽ معيار جي ڪنٽرول جي چوڌاري ٺهيل آهن جيڪي مسلسل ترتيب واري ڊيٽا کي سپورٽ ڪن ٿا.
هڪ تشبيه: پرواز جا ڪلاڪ بمقابله پرواز جي هدايت
آر ايل ٽريننگ کي پائلٽ ٽريننگ وانگر سوچيو. توهان صرف هڪ سموليٽر ۾ لامحدود ڪلاڪ لاگ ان ڪري سگهو ٿا - پر جيڪڏهن توهان غلط عادتن تي عمل ڪندا، ته توهان انهن کي مضبوط ڪندا. هڪ انسٽرڪٽر صرف "پاس/فيل" نٿو چوي. اهي توهان جي استدلال کي وچ ۾ درست ڪن ٿا: اسڪين آرڊر، فيصلي جو وقت، ۽ خطري کي سنڀالڻ. ماهر-ويٽيڊ استدلال ڊيٽاسيٽس آر ايل لاءِ اهو "انسٽرڪٽر" ڪردار ادا ڪن ٿا - ماڊل کي سيکارڻ ته ڪم ذريعي ڪيئن سوچڻو آهي، نه ته صرف اهو ته اهو لينڊ ٿيو يا نه.
مقابلي جي جدول: گھر اندر بمقابلہ ڪراؤڊ سورسڊ بمقابلہ آئوٽ سورسڊ ويٽنگ ماڊل
گهڻيون ٽيمون هڪ هائبرڊ سان ختم ٿين ٿيون، پر اهو واپار جي باري ۾ واضح هجڻ ۾ مدد ڪري ٿو.
وسيع ليبلنگ جي ضرورتن لاءِ جيڪي RL ۽ RLHF پائپ لائنن سان ڳنڍيل آهن، Shaip جون ڊيٽا اينوٽيشن سروسز گائيڊ لائن ڊيزائن کان وٺي ملٽي اسٽيج QA تائين هر شيءِ جي مدد ڪري سگهن ٿيون - خاص طور تي جڏهن توهان کي پيماني تي ورجائي سگهڻ واري معيار جي ضرورت هجي.
ماهر-ويٽيڊ استدلال ڊيٽاسيٽس لاءِ هڪ عملي QC پلي بڪ
هتي هڪ پلي بڪ آهي جيڪا اعليٰ ڪارڪردگي واريون ٽيمون ڪهڙيون ڪم ڪن ٿيون ان جو نقشو ٺاهي ٿي.
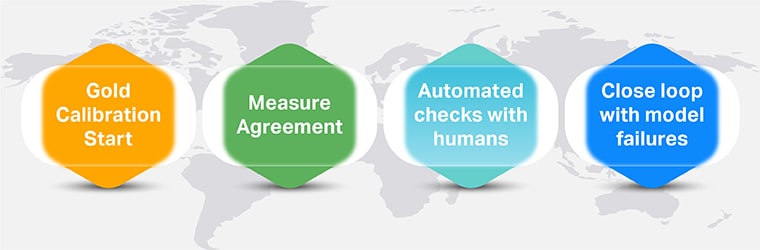
1. "سون" ۽ ڪيليبريشن سان شروع ڪريو
ڪيننيڪل مثالن جو هڪ سونهري سيٽ ٺاهيو (ٽريڪي ايج ڪيسز سميت). ان کي استعمال ڪريو اينوٽيٽرز کي ڪيليبريٽ ڪرڻ ۽ ماهرن کي ترتيب ڏيڻ لاءِ ته "سٺو استدلال" ڪيئن نظر اچي ٿو.
2. اتفاق کي ماپيو - پوءِ اختلافن کي صحيح طريقي سان حل ڪريو
جتي سمجهه ۾ اچي اتي بين-تشريح ڪندڙ معاهدي کي استعمال ڪريو (۽ فطري طور تي مبهم ڪيسن تي معاهدي کي مجبور ڪرڻ کان پاسو ڪريو). اهم ڳالهه ثالثي آهي : اختلافن کي بهتر هدايتون پيدا ڪرڻ گهرجن، نه ته صرف سڪا ڦٽڻ جو ليبل.
3. خودڪار چيڪ شامل ڪريو، پر انسانن کي انچارج رکو
خودڪار طريقي سان تصديق ڪريو ته ڇا سستو آهي:
- فارميٽ جي تسلسل (قدم جي ڳڻپ، اسڪيما جي صحيحيت)
- ضابطن جي ڀڃڪڙي (لاپتا پابنديون، منع ٿيل ڪارناما)
- تضاد جي ڳولا (قدم "الف" چوي ٿو، بعد ۾ "الف نه" جو مطلب آهي)
پوءِ نشان لڳل شين کي ماهر جائزي ڏانهن موڪليو. هي اهو هنڌ آهي جتي هائبرڊ هيومن + اي آءِ ڪيو سي فائدو ڏئي ٿو: مشينون "واضح غلطي" کي پڪڙين ٿيون، ماهر "نازڪ غلطي" کي درست ڪن ٿيون.
4. ماڊل ناڪامين سان لوپ بند ڪريو
ڊيپلائيمينٽ ناڪامين کي ڊيٽا سيٽ موٽ جي طور تي سمجهو. جڏهن ماڊل ناڪام ٿئي ٿو، پڇو:
- ڇا دليل جي نشان ۾ ڪا رڪاوٽ غائب هئي؟
- ڇا هدايتون ايج ڪيس کي گهٽ بيان ڪن ٿيون؟
- ڇا اسان "خوشيءَ واري رستي" واري منطق تي اوور فٽ ٿي ويا آهيون؟
اهو لوپ توهان جي ڊيٽا سيٽ کي هڪ زنده اثاثي ۾ تبديل ڪري ٿو، هڪ ڀيرو پهچائڻ وارو نه. ٽيمن لاءِ ڊيٽا پائپ لائنون ٺاهڻ لاءِ اينڊ-ٽو-اينڊ (ڪليڪشن → QA → ڊليوري)، شيپ جون AI ٽريننگ ڊيٽا سروسز هن کي مسلسل هلائڻ ۾ مدد ڪري سگهن ٿيون.
فيصلي جو فريم ورڪ: صحيح چڪاس جي حڪمت عملي ڪيئن چونڊجي
گھر اندر، ميڙ ۾، ۽ منظم خدمتن جو صحيح ميلاپ چونڊڻ لاءِ انهن ڇهن سوالن کي استعمال ڪريو: