AI ڊيٽا گڏ ڪرڻ: اهو ڇا آهي ۽ اهو ڪيئن ڪم ڪري ٿو

عمل، طريقا، بهترين طريقا، فائدا، چئلينج، قيمتون، حقيقي دنيا جي مثال ۽ صحيح ڊيٽا گڏ ڪرڻ واري ساٿي کي ڪيئن چونڊيو وڃي سکو.

مواد جي جدول

اي بک ڊائون لوڊ ڪريو

ڊيٽا گڏ ڪرڻ bg_tablet

تعارف

اي ٽريننگ ڊيٽا

مصنوعي ذهانت (AI) هاڻي روزمره جي ڪم جو حصو آهي - چيٽ بوٽس، ڪوپائلٽس، ۽ ملٽي ماڊل ٽولز کي طاقت ڏئي ٿو جيڪي ٽيڪسٽ، تصويرون ۽ آڊيو کي سنڀاليندا آهن. اپنائڻ تيز ٿي رهيو آهي: ميڪ ڪينزي رپورٽ ڪري ٿو ته 88٪ تنظيمون گهٽ ۾ گهٽ هڪ ڪاروباري فنڪشن ۾ AI استعمال ڪن ٿيون . مارڪيٽ جي واڌ پڻ وڌي رهي آهي، هڪ اندازي سان 2025 ۾ AI جي قيمت ~$390.9B ۽ 2033 تائين ~ $3.5T جو اندازو لڳايو ويو آهي.

هر مضبوط AI سسٽم جي پويان ساڳيو بنياد آهي: اعليٰ معيار جو ڊيٽا . هي گائيڊ وضاحت ڪري ٿو ته ڪيئن صحيح ڊيٽا گڏ ڪجي، معيار ۽ تعميل کي برقرار رکيو وڃي، ۽ پنهنجي AI منصوبن لاءِ بهترين طريقو (ان-هاؤس، آئوٽ سورس، يا هائبرڊ) چونڊيو وڃي.

AI ڊيٽا گڏ ڪرڻ ڇا آهي؟

AI ڊيٽا گڏ ڪرڻ ڊيٽاسيٽس ٺاهڻ جو عمل آهي جيڪي ماڊل ٽريننگ ۽ تشخيص لاءِ تيار آهن - صحيح سگنلن کي سورس ڪندي، انهن کي صاف ڪرڻ ۽ structure ڪرڻ، ميٽا ڊيٽا شامل ڪرڻ، ۽ جتي ضرورت هجي اتي ليبلنگ ڪندي. اهو صرف "ڊيٽا حاصل ڪرڻ" ناهي. اهو يقيني بڻائي رهيو آهي ته ڊيٽا لاڳاپيل، قابل اعتماد، حقيقي دنيا جي استعمال لاءِ ڪافي متنوع آهي، ۽ بعد ۾ آڊٽ ڪرڻ لاءِ ڪافي دستاويزي آهي.

AI منصوبن لاءِ سڀ کان وڌيڪ عام ڊيٽا فارميٽ

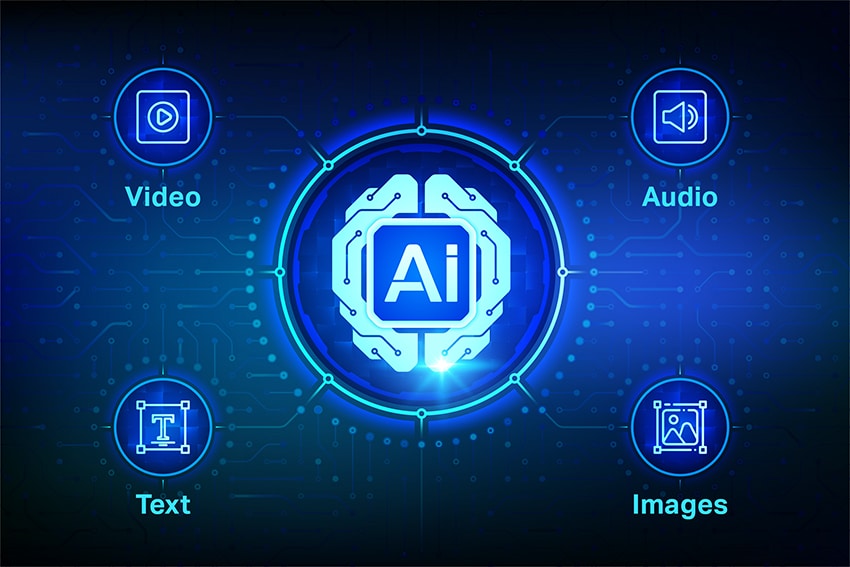
AI ڊيٽا سيٽ عام طور تي چار وڏين قسمن ۾ ورهايل آهن، ان سسٽم تي منحصر آهي جيڪو توهان ٺاهي رهيا آهيو:

  • ٽيڪسٽ ڊيٽا: متن تربيتي ڊيٽا جي سڀ کان وڌيڪ استعمال ٿيندڙ شڪلن مان هڪ آهي. اهو ٿي سگهي ٿو جوڙجڪ (ٽيبل، ڊيٽابيس، سي آر ايم ريڪارڊ، فارم) يا بناوت (اي ميل، چيٽ لاگز، سروي، دستاويز، سوشل ميڊيا تبصرا). ايل ايل ايم ۽ چيٽ بوٽس لاءِ، ٽيڪسٽ ڊيٽا ۾ اڪثر ڪري علم جي بنياد تي آرٽيڪل، سپورٽ ٽڪيٽون، ۽ سوال-جواب جوڙا شامل هوندا آهن.
  • آڊيو ڊيٽا: آڊيو ڊيٽا وائس اسسٽنٽ، ڪال اينالائيٽڪس، ۽ وائس تي ٻڌل چيٽ بوٽس جهڙن اسپيچ سسٽم کي تربيت ڏيڻ ۽ بهتر ڪرڻ ۾ مدد ڪري ٿو. اهي ڊيٽا سيٽ حقيقي دنيا جي تبديلين کي پڪڙيندا آهن جهڙوڪ تلفظ، تلفظ، پس منظر جو شور، ۽ مختلف طريقا جيڪي ماڻهو ساڳيو سوال پڇن ٿا. عام مثالن ۾ ڪال سينٽر رڪارڊنگ، وائس ڪمانڊ، ۽ گهڻ لساني اسپيچ نمونا شامل آهن.
  • تصويري ڊيٽا: تصويري ڊيٽا سيٽ ڪمپيوٽر جي نظر کي طاقت ڏين ٿا جيئن ته شيون ڳولڻ، طبي تصويري تجزيو، پرچون پراڊڪٽ جي سڃاڻپ، ۽ سڃاڻپ جي تصديق. تصويرن کي اڪثر ليبلن جي ضرورت هوندي آهي جهڙوڪ ٽيگ، باؤنڊنگ باڪس، يا سيگمينٽيشن ماسڪ ته جيئن ماڊل سکي سگهن ته اهي ڇا ڏسي رهيا آهن.
  • وڊيو ڊيٽا: وڊيو بنيادي طور تي وقت سان گڏ تصويرن جو هڪ سلسلو آهي، جيڪو ان کي حرڪت ۽ تناظر جي گهري سمجھ لاءِ ڪارآمد بڻائي ٿو. وڊيو ڊيٽا سيٽ ايپليڪيشنن کي سپورٽ ڪن ٿا جهڙوڪ خودمختيار ڊرائيونگ، نگراني تجزياتي، راندين جو تجزيو، ۽ صنعتي حفاظت جي نگراني - اڪثر ڪري فريم بائي فريم ليبلنگ يا ايونٽ ٽيگنگ جي ضرورت هوندي آهي.

2026 ۾، AI ڊيٽا گڏ ڪرڻ مختلف نظر اچي ٿو ڇاڪاڻ ته ڪيترائي سسٽم LLM چيٽ بوٽس، RAG (Retrieval-augmented generation)، ۽ ملٽي ماڊل ماڊلز ذريعي طاقتور آهن . ان جو مطلب آهي ته ٽيمون متوازي طور تي ٽن قسمن جو ڊيٽا گڏ ڪن ٿيون: سکيا ڊيٽا (رويي کي سيکارڻ لاءِ)، گرائونڊنگ ڊيٽا (صحيح جوابن لاءِ RAG تيار دستاويز)، ۽ تشخيص ڊيٽا (واپس آڻڻ جي درستگي، هيلوسينيشن، ۽ پاليسي الائنمينٽ کي ماپڻ لاءِ).
اي ڊيٽا گڏ ڪرڻ

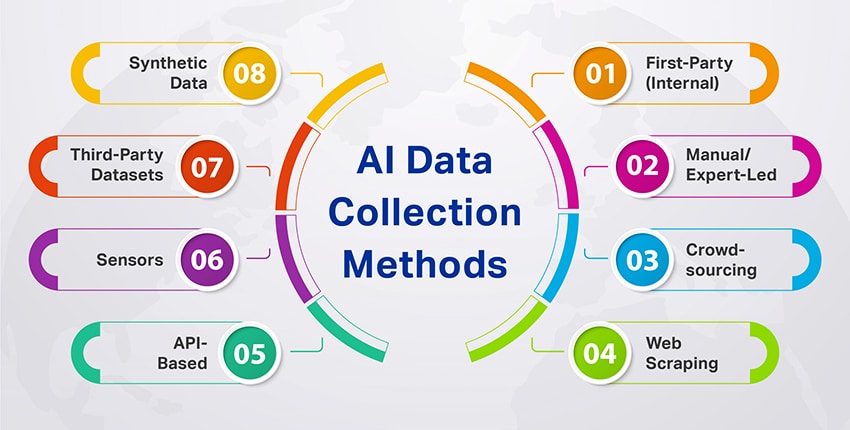
AI ڊيٽا گڏ ڪرڻ جي طريقن جا قسم

Ai ڊيٽا گڏ ڪرڻ جا طريقا

1. پهرين پارٽي (اندروني) ڊيٽا گڏ ڪرڻ

توهان جي پنهنجي پراڊڪٽ، استعمال ڪندڙن ۽ آپريشنز مان گڏ ڪيل ڊيٽا - عام طور تي سڀ کان وڌيڪ قيمتي ڇاڪاڻ ته اهو حقيقي رويي کي ظاهر ڪري ٿو.

مثال: سپورٽ ٽڪيٽون، سرچ لاگز، ۽ چيٽ بوٽ گفتگوون (رضامندي سان) برآمد ڪرڻ، پوءِ انهن کي مسئلي جي قسم جي لحاظ کان ترتيب ڏيڻ ته جيئن LLM سپورٽ اسسٽنٽ کي بهتر بڻائي سگهجي.

2. دستي/ماهر جي اڳواڻي ۾ ڪليڪشن

انسان جان بوجھ ڪري ڊيٽا گڏ ڪندا آهن يا ٺاهيندا آهن جڏهن گهري تناظر، ڊومين جي ڄاڻ، يا اعليٰ درستگي جي ضرورت هوندي آهي.

مثال: طبي رپورٽن جو جائزو وٺندڙ طبي ماهر ۽ صحت جي سار سنڀال جي NLP ماڊل کي تربيت ڏيڻ لاءِ اهم نتيجن کي ليبل ڪندڙ.

3. ڪراؤڊ سورسنگ (ورهايل انساني افرادي قوت)

وڏي پيماني تي ڊيٽا گڏ ڪرڻ يا ليبل ڪرڻ لاءِ ڪارڪنن جي هڪ وڏي پول کي استعمال ڪندي. معيار کي واضح هدايتن، گھڻن نظرثاني ڪندڙن، ۽ ٽيسٽ سوالن جي استعمال سان برقرار رکيو ويندو آهي.

مثال: ڪراؤڊ ورڪرز تقرير جي سڃاڻپ لاءِ هزارين مختصر آڊيو ڪلپس نقل ڪن ٿا، درستگي جي جانچ لاءِ "گولڊ" ٽيسٽ ڪلپس سان.

4. ويب ڊيٽا ڪليڪشن (اسڪريپنگ)

عوامي ويب سائيٽن تان خودڪار طريقي سان معلومات کي پيماني تي ڪڍڻ (صرف جڏهن شرطن ۽ قانونن جي اجازت هجي). هن ڊيٽا کي اڪثر ڪري سخت صفائي جي ضرورت هوندي آهي.

مثال: ٺاهيندڙ صفحن مان عوامي پراڊڪٽ وضاحتون گڏ ڪرڻ ۽ گندي ويب مواد کي پراڊڪٽ سان ملندڙ ماڊل لاءِ منظم شعبن ۾ تبديل ڪرڻ.

5. API تي ٻڌل ڊيٽا گڏ ڪرڻ

سرڪاري APIs ذريعي ڊيٽا ڪڍڻ، جيڪي عام طور تي اسڪريپنگ کان وڌيڪ مسلسل، قابل اعتماد، ۽ منظم ڊيٽا مهيا ڪن ٿا.

مثال: اڳڪٿي يا بي ضابطگي جي ڳولا لاءِ قيمت/وقت-سيريز ڊيٽا گڏ ڪرڻ لاءِ مالي مارڪيٽ API استعمال ڪرڻ.

6. سينسر ۽ آئي او ٽي ڊيٽا ڪليڪشن

ڊوائيسز ۽ سينسرز (درجه حرارت، وائبريشن، GPS، ڪئميرا، وغيره) مان مسلسل وهڪري کي پڪڙڻ، اڪثر ڪري حقيقي وقت جي فيصلن لاءِ.

مثال: ڪارخاني جي مشينن مان وائبريشن ۽ گرمي پد جا سگنل گڏ ڪرڻ، پوءِ سار سنڀال جي لاگ کي اڳڪٿي ڪندڙ سار سنڀال لاءِ ليبل طور استعمال ڪرڻ.

7. ٽئين پارٽي/لائسنس يافته ڊيٽا سيٽس

ترقي کي تيز ڪرڻ يا ڪوريج جي خالن کي ڀرڻ لاءِ وينڊرز يا مارڪيٽن کان تيار ٿيل ڊيٽا سيٽ خريد ڪرڻ يا لائسنس ڏيڻ.

مثال: هڪ وائيس پراڊڪٽ لانچ ڪرڻ لاءِ هڪ گهڻ لساني تقرير ڊيٽا سيٽ کي لائسنس ڏيڻ، پوءِ پنهنجي استعمال ڪندڙن لاءِ ڪارڪردگي بهتر ڪرڻ لاءِ پهرين پارٽي رڪارڊنگ شامل ڪرڻ.

8. مصنوعي ڊيٽا جي پيداوار

رازداري جي پابندين، نادر واقعن، يا طبقاتي عدم توازن کي سنڀالڻ لاءِ مصنوعي ڊيٽا ٺاهڻ. مصنوعي ڊيٽا کي حقيقي دنيا جي نمونن جي خلاف تصديق ڪيو وڃي.

مثال: جڏهن حقيقي فراڊ جون مثالون محدود هجن ته ڳولا کي بهتر بڻائڻ لاءِ ناياب فراڊ ٽرانزيڪشن نمونن کي پيدا ڪرڻ.

ڇو ڊيٽا جي معيار AI ڪاميابي جو تعين ڪري ٿي

مصنوعي ذهانت جي صنعت هڪ موڙ تي پهچي چڪي آهي: بنيادي ماڊل آرڪيٽيڪچر هڪ ٻئي سان ملائي رهيا آهن، پر ڊيٽا جي معيار انهن شين جي وچ ۾ بنيادي فرق رهي ٿي جيڪي صارفين کي خوش ڪن ٿيون ۽ انهن کي مايوس ڪن ٿيون.

خراب تربيتي ڊيٽا جي قيمت

خراب ڊيٽا معيار انهن طريقن سان ظاهر ٿئي ٿو جيڪي ماڊل جي ڪارڪردگي کان گهڻو اڳتي وڌن ٿا:

ماڊل ناڪاميون : وهم، حقيقتن جون غلطيون، ۽ سر جي غير مطابقت سڌو سنئون تربيتي ڊيٽا جي فرقن سان ڳنڍيل آهن. نامڪمل پراڊڪٽ دستاويزن تي تربيت يافته ڪسٽمر سپورٽ چيٽ بوٽ اعتماد سان غلط جواب فراهم ڪندو.

تعميل جي نمائش : ڊيٽا سيٽ جيڪي اجازت کان سواءِ اسڪريپ ڪيا ويا آهن يا جن ۾ غير لائسنس يافته ڪاپي رائيٽ ٿيل مواد شامل آهي، قانوني ذميواري پيدا ڪن ٿا. 2024-2025 ۾ ڪيترن ئي هاءِ پروفائل ڪيسن اهو ثابت ڪيو آهي ته "اسان کي خبر نه هئي" هڪ قابل عمل دفاع نه آهي.

ٻيهر تربيت جا خرچ : ڊيٽا جي معيار جي مسئلن کي ڊيپلائيمينٽ کان پوءِ دريافت ڪرڻ جو مطلب آهي مهانگو ٻيهر تربيت جا چڪر ۽ دير سان روڊ ميپ. انٽرپرائز ٽيمون رپورٽ ڪن ٿيون ته ايم ايل پروجيڪٽ جي وقت جو 40-60٪ ڊيٽا تيار ڪرڻ ۽ اصلاح تي خرچ ڪن ٿيون.

ڳولڻ لاءِ معيار جا سگنل

جڏهن تربيتي ڊيٽا جو جائزو ورتو وڃي - ڇا اهو وڪرو ڪندڙ کان هجي يا اندروني ذريعن کان - اهي ميٽرڪس اهم آهن:

  • آبادي ۽ لساني تنوع: عالمي سطح تي تعیناتين لاءِ، ڇا ڊيٽا توهان جي اصل صارف بنياد جي نمائندگي ڪري ٿو؟
  • تشريح جي کوٽائي: ڇا تشريحون بائنري ليبل آهن يا امير، گھڻ-وصف واريون تشريحون جيڪي nuance کي پڪڙين ٿيون؟
  • ليبل جي تسلسل: ڇا ليبل هڪجهڙا رهن ٿا جڏهن ساڳئي شيءِ جو ٻه ڀيرا جائزو ورتو وڃي ٿو؟
  • ايج ڪيس ڪوريج: ڇا ڊيٽا ۾ ناياب پر اهم منظرنامو شامل آهي، يا صرف "خوشيءَ جو رستو"؟
  • وقتي لاڳاپو: ڇا توهان جي ڊومين لاءِ موجوده ڊيٽا ڪافي آهي؟ مالي يا خبرن تي ٻڌل ماڊلز کي تازي ڊيٽا جي ضرورت آهي.

ڊيٽا گڏ ڪرڻ جو عمل: گهرجن کان ماڊل تيار ڊيٽا سيٽ تائين

هڪ اسڪيلبل اي آءِ ڊيٽا گڏ ڪرڻ وارو عمل ورجائي سگهجي ٿو، ماپي سگهجي ٿو، ۽ تعميل ڪري سگهجي ٿو - خام فائلن جو هڪ ڀيرو ڊمپ نه. گھڻن اي آءِ/ايم ايل شروعاتن لاءِ، آخري مقصد واضح آهي: هڪ مشين تيار ڊيٽا سيٽ جيڪو ٽيمون قابل اعتماد طور تي ٻيهر استعمال ڪري سگهن ٿيون، آڊٽ ڪري سگهن ٿيون، ۽ وقت سان گڏ بهتر بڻائي سگهن ٿيون.
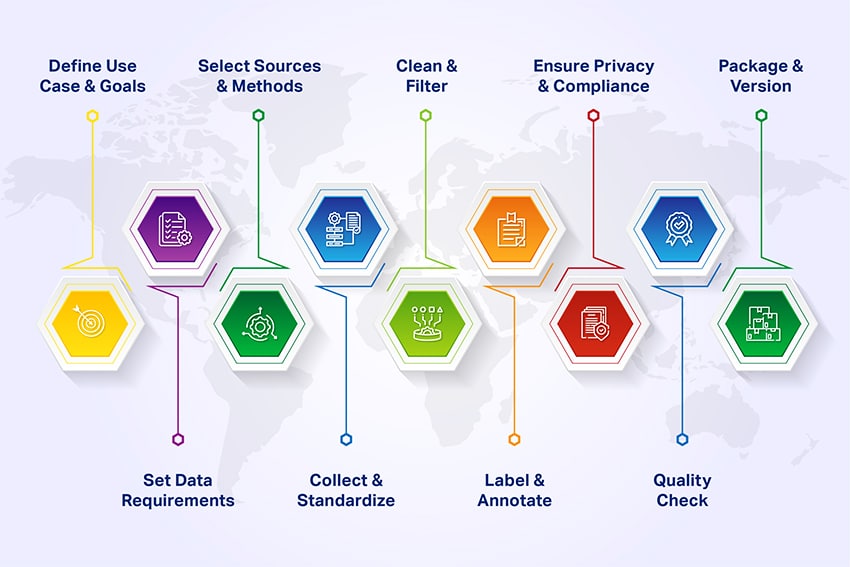
ڊيٽا گڏ ڪرڻ جو عمل

1. استعمال جي ڪيس ۽ ڪاميابي جي ميٽرڪس جي وضاحت ڪريو

ڪاروباري مسئلي سان شروع ڪريو، ڊيٽا سان نه.

  • هي ماڊل ڪهڙي مسئلي کي حل ڪري رهيو آهي؟
  • پيداوار ۾ ڪاميابي ڪيئن ماپي ويندي؟

مثالون:

  • "6 مهينن دوران سپورٽ جي واڌ کي 15 سيڪڙو گهٽايو."
  • "مٿين 50 خود سروس سوالن لاءِ حاصل ڪرڻ جي درستگي کي بهتر بڻايو."
  • "پيداوار ۾ خرابي جي سڃاڻپ جي يادگيري کي 10 سيڪڙو وڌايو."

اهي هدف بعد ۾ ڊيٽا جي مقدار، ڪوريج، ۽ معيار جي حد کي هلائيندا آهن.

2. ڊيٽا جي گهرجن جي وضاحت ڪريو

استعمال جي ڪيس کي ڪنڪريٽ ڊيٽا جي وضاحتن ۾ ترجمو ڪريو.

  • ڊيٽا جا قسم: متن، آڊيو، تصوير، وڊيو، ٽيبلولر، يا هڪ مرکب
  • حجم جون حدون: شروعاتي پائلٽ بمقابله مڪمل رول آئوٽ (مثال طور، 10K → 100K+ نمونا)
  • ٻوليون ۽ علائقا: گهڻ لساني، لهجا، لهجا، علائقائي شڪلون
  • ماحول خاموش بمقابله شور، ڪلينڪل بمقابله صارف، ڪارخانو بمقابله آفيس
  • ايج ڪيس: ناياب پر اعليٰ اثر وارا منظرنامو جيڪي توهان وڃائڻ جي متحمل نٿا ٿي سگهو
  • ڊيٽا جي حد: ڏهه هزار رڪارڊ جيڪي سڀ هڪجهڙا نظر اچن ٿا، ٻن هزارن کان گهٽ ڪارڪردگي ڏيکاريندا جيڪي حالتن، ڊيموگرافڪس، دستاويزن جي قسمن ۽ ايج ڪيسن تي مشتمل هوندا جيڪي ماڊل پيداوار ۾ ملندا. 

هي "ڊيٽا جي گهرج جي وضاحت" اندروني ٽيمن ۽ ٻاهرين ڊيٽا وينڊرز ٻنهي لاءِ سچائي جو واحد ذريعو بڻجي ٿي.

3. گڏ ڪرڻ جا طريقا ۽ ذريعا چونڊيو

هن مرحلي تي، توهان فيصلو ڪندا ته توهان جو ڊيٽا ڪٿان ايندو. عام طور تي، ٽيمون ٽي مکيه ذريعا گڏ ڪن ٿيون:

  • مفت/عوامي ڊيٽا سيٽ: تجربن ۽ بينچ مارڪنگ لاءِ ڪارآمد، پر اڪثر ڪري توهان جي ڊومين، لائسنسنگ جي ضرورتن، يا ٽائم لائنن سان غلط ترتيب ڏنل هوندو آهي.
  • اندروني ڊيٽا: سي آر ايم، سپورٽ ٽڪيٽون، لاگز، طبي رڪارڊ، پراڊڪٽ جي استعمال جو ڊيٽا - انتهائي لاڳاپيل، پر خام، گهٽ، يا حساس ٿي سگهي ٿو.
  • ادا ڪيل/لائسنس يافته ڊيٽا وينڊرز: بهترين جڏهن توهان کي ڊومين-مخصوص، اعليٰ معيار، تشريح ٿيل، ۽ پيماني تي مطابقت رکندڙ ڊيٽاسيٽس جي ضرورت هجي.

گهڻا ڪامياب منصوبا انهن کي گڏ ڪن ٿا:

  • پروٽوٽائپنگ لاءِ عوامي ڊيٽا استعمال ڪريو.
  • ڊومين جي مطابقت لاءِ اندروني ڊيٽا استعمال ڪريو.
  • جڏهن توهان کي پيماني، تنوع، تعميل، ۽ ماهر تشريح جي ضرورت هجي ته اندروني ٽيمن کي اوورلوڊ ڪرڻ کان سواءِ شيپ جهڙن وينڊرز کي استعمال ڪريو.

مصنوعي ڊيٽا ڪجهه حالتن ۾ حقيقي دنيا جي ڊيٽا کي پڻ پورو ڪري سگهي ٿو (مثال طور، نادر واقعا، ڪنٽرول ٿيل تبديليون)، پر مڪمل طور تي حقيقي ڊيٽا کي تبديل نه ڪرڻ گهرجي.

4. ڊيٽا گڏ ڪريو ۽ معياري بڻايو

جيئن ڊيٽا اچڻ شروع ٿئي ٿي، معياري ڪرڻ بعد ۾ انتشار کي روڪي ٿو.

  • مسلسل فائل فارميٽ لاڳو ڪريو (مثال طور، آڊيو لاءِ WAV، ميٽا ڊيٽا لاءِ JSON، تصوير لاءِ DICOM).
  • رچ ميٽا ڊيٽا ڪيپچر ڪريو: تاريخ/وقت، مقامي، ڊوائيس، چينل، ماحول، رضامندي جي حيثيت، ۽ ذريعو.
  • اسڪيما ۽ آنٽولوجي تي ترتيب ڏيو: ڪيئن ليبل، ڪلاس، ارادا، ۽ ادارا نالا ۽ ترتيب ڏنل آهن.

هي اهو هنڌ آهي جتي هڪ سٺو وينڊر توهان جي ٽيمن ڏانهن خام، متضاد فائلن کي دٻائڻ جي بدران، توهان جي پسنديده اسڪيما ۾ ڊيٽا پهچائيندو.

5. صاف ۽ فلٽر ڪريو

خام ڊيٽا گندو آهي. صفائي يقيني بڻائي ٿي ته صرف مفيد، قابل استعمال، ۽ قانوني ڊيٽا اڳتي وڌي.

عام ڪارناما شامل آهن:

  • نقل ۽ ويجھي نقل کي ختم ڪرڻ
  • خراب، گهٽ معيار، يا نامڪمل نمونن کي خارج ڪرڻ
  • دائري کان ٻاهر مواد کي فلٽر ڪرڻ (غلط ٻولي، غلط ڊومين، غلط ارادو)
  • فارميٽ کي عام ڪرڻ (ٽيڪسٽ انڪوڊنگ، نموني جي شرح، قراردادون)

صفائي اڪثر ڪري اهڙي جاءِ آهي جتي اندروني ٽيمون ڪوشش کي گهٽ سمجهن ٿيون. هن قدم کي هڪ خاص فراهم ڪندڙ کي آئوٽ سورس ڪرڻ سان مارڪيٽ تائين پهچڻ جو وقت گهٽجي سگهي ٿو.

6. ليبل ۽ تشريح ڪريو (جڏهن گهربل هجي)

نگراني ڪيل ۽ انساني-ان-دي-لوپ سسٽم کي مسلسل، اعليٰ معيار جي ليبلن جي ضرورت آهي.

استعمال جي صورت تي مدار رکندي، هن ۾ شامل ٿي سگھي ٿو:

  • چيٽ بوٽس ۽ ورچوئل اسسٽنٽس لاءِ ارادا ۽ ادارا
  • تقرير ۽ ڪال اينالائيٽڪس لاءِ ٽرانسڪرپٽ ۽ اسپيڪر ليبل
  • ڪمپيوٽر ويزن لاءِ باؤنڊنگ باڪس، پوليگون، يا سيگمينٽيشن ماسڪ
  • ڳولا ۽ RAG سسٽم لاءِ لاڳاپيل فيصلا ۽ درجه بندي ليبل
  • صحت جي سار سنڀال لاءِ ICD ڪوڊ، دوائون، ۽ ڪلينڪل تصورات NLP

اهم ڪاميابي جا عنصر:

  • واضح، تفصيلي تشريح جون هدايتون
  • تشريح ڪندڙن لاءِ تربيت ۽ موضوع جي ماهرن تائين رسائي
  • مبهم ڪيسن لاءِ اتفاق راءِ جا ضابطا
  • تسلسل کي ٽريڪ ڪرڻ لاءِ بين تشريح ڪندڙ معاهدي جي ماپ

صحت جي سار سنڀال يا ماليات جهڙن خاص شعبن لاءِ، عام ڪراؤڊ اينوٽيشن ڪافي ناهي. توهان کي SMEs ۽ آڊٽ ٿيل ورڪ فلو جي ضرورت آهي - بلڪل جتي شيپ جهڙو پارٽنر قدر آڻيندو آهي.

7. رازداري، سيڪيورٽي، ۽ تعميل ڪنٽرول لاڳو ڪريو

ڊيٽا گڏ ڪرڻ کي پهرين ڏينهن کان ئي ريگيوليٽري ۽ اخلاقي حدن جو احترام ڪرڻ گهرجي.

عام ڪنٽرول ۾ شامل آهن:

  • ذاتي ۽ حساس ڊيٽا جي سڃاڻپ ختم ڪرڻ/گمنام ڪرڻ
  • رضامندي جي ٽريڪنگ ۽ ڊيٽا جي استعمال جون پابنديون
  • برقرار رکڻ ۽ ختم ڪرڻ جون پاليسيون
  • ڪردار تي ٻڌل رسائي ڪنٽرول ۽ ڊيٽا انڪرپشن
  • GDPR، HIPAA، CCPA، ۽ صنعت جي مخصوص ضابطن جهڙن معيارن جي پاسداري

هڪ تجربيڪار ڊيٽا پارٽنر انهن گهرجن کي گڏ ڪرڻ، تشريح، ترسيل، ۽ اسٽوريج ۾ شامل ڪندو، انهن کي بعد ۾ سوچڻ جي طور تي نه سمجهندو.

8. معيار جي ضمانت ۽ قبوليت جي جاچ

ڪنهن ڊيٽا سيٽ کي "ماڊل-ريڊي" قرار ڏيڻ کان اڳ، ان کي منظم QA مان گذرڻ گهرجي.

عام طريقا:

  • نموني ۽ آڊٽ: هر بيچ مان بي ترتيب نمونن جو انساني جائزو
  • سون جا سيٽ: هڪ ننڍڙو، ماهر-ليبل ٿيل ريفرنس سيٽ جيڪو اينوٽيٽر جي ڪارڪردگي جو جائزو وٺڻ لاءِ استعمال ٿيندو آهي.
  • نقص جي ٽريڪنگ: مسئلن جي درجه بندي (غلط ليبل، گم ٿيل ليبل، فارميٽنگ جي غلطي، تعصب، وغيره)
  • قبوليت جا معيار: درستگي، ڪوريج، ۽ تسلسل لاءِ اڳ ۾ بيان ڪيل حدون

صرف جڏهن ڪو ڊيٽا سيٽ انهن معيارن تي پورو لهي ٿو ته ان کي تربيت، تصديق، يا تشخيص ڏانهن وڌايو وڃي.

9. ٻيهر استعمال لاءِ پيڪيج، دستاويز، ۽ نسخو

آخرڪار، ڊيٽا اڄ استعمال لائق ۽ سڀاڻي ٻيهر پيدا ڪرڻ لائق هجڻ گهرجي.

بهترين طريقا:

  • واضح اسڪيمن، ليبل ٽيڪسونوميز، ۽ ميٽا ڊيٽا جي تعريفن سان پيڪيج ڊيٽا
  • دستاويز شامل ڪريو: ڊيٽا جا ذريعا، گڏ ڪرڻ جا طريقا، ڄاڻايل حدون، ۽ ارادو استعمال.
  • ورجن ڊيٽاسيٽس ته جيئن ٽيمون ٽريڪ ڪري سگهن ته ڪهڙو ورجن ڪهڙي ماڊل، تجربي، يا رليز لاءِ استعمال ڪيو ويو هو.
  • پاڇو ڊيٽاسيٽس ۽ نقل ڪيل ڪوشش کان بچڻ لاءِ ڊيٽاسيٽس کي اندروني طور تي (۽ محفوظ طور تي) دريافت ڪرڻ لائق بڻايو.

گھر ۾ بمقابلہ آئوٽ سورس بمقابلہ هائبرڊ: توهان کي ڪهڙو ماڊل چونڊڻ گهرجي؟

گهڻيون ٽيمون هميشه لاءِ صرف هڪ طريقو نه چونڊينديون آهن. بهترين ماڊل ڊيٽا جي حساسيت، رفتار، پيماني تي منحصر آهي، ۽ توهان جي ڊيٽا سيٽ کي ڪيتري وقت اپڊيٽ جي ضرورت آهي (خاص طور تي RAG ۽ پيداوار چيٽ بوٽس لاءِ صحيح).

ماڊل هن جو ڇا مطلب بهترين جڏهن واپار بند عام 2026 حقيقت
گھر ۾ توهان جي ٽيم سورسنگ، ڪليڪشن، QA، ۽ اڪثر ليبلنگ کي سنڀاليندي آهي. ڊيٽا انتهائي حساس آهي، ڪم جو وهڪرو منفرد آهي، ۽ مضبوط اندروني آپريشن موجود آهن. ڀرتي ۽ اوزارن جي فراهمي ۾ وقت لڳندو آهي؛ اسڪيلنگ ڏکيو آهي؛ QA هڪ رڪاوٽ بڻجي سگهي ٿو. مستقل مقدار ۽ سخت گورننس جي ضرورتن سان بالغ ٽيمن لاءِ ڪم ڪري ٿو.
ٻاهريون ذريعو وينڊر ڪليڪشن، ليبلنگ، ۽ QA کي آخر کان آخر تائين منظم ڪري ٿو. توهان کي رفتار، عالمي پيماني تي، گهڻ لساني ڪوريج، يا خاص ڊيٽا گڏ ڪرڻ جي ضرورت آهي. مضبوط وضاحتن ۽ وينڊر مئنيجمينٽ جي ضرورت آهي؛ گورننس واضح هجڻ گهرجي. وڏي اندروني ٽيم ٺاهڻ کان سواءِ پائلٽس ۽ تيز اسڪيلنگ لاءِ مثالي.
ھائبرڊ حساس حڪمت عملي ۽ گورننس گهر ۾ رهندي آهي؛ عملدرآمد ۽ پيمانو آئوٽ سورس ڪيو ويندو آهي. توهان کي ڪنٽرول ۽ رفتار گهرجي، بار بار ريفريش جي ضرورت آهي، ۽ تعميل جون پابنديون آهن. وضاحتن، قبوليت جي معيار، ۽ ورزننگ ۾ واضح هٿ جي ضرورت آهي. ايل ايل ايم ۽ آر اي جي پروگرامن لاءِ سڀ کان عام انٽرپرائز سيٽ اپ.

ڊيٽا گڏ ڪرڻ جي چئلينجز

گهڻيون ناڪاميون اڳڪٿي لائق چئلينجن مان اينديون آهن. انهن لاءِ جلد منصوبابندي ڪريو:

  • لاڳاپيل فرق: ڊيٽا موجود آهي، پر اهو توهان جي حقيقي استعمال جي صورت سان نه ٿو ملي (غلط ڊومين، غلط استعمال ڪندڙ ارادو، پراڻو مواد).
  • ڪوريج جا خال: گم ٿيل ٻوليون، تلفظ، آبادي، ڊوائيسز، ماحول، يا "نادر پر اهم" منظرنامو.
  • واس: ڊيٽا سيٽ ڪجهه گروپن يا حالتن جي وڌيڪ نمائندگي ڪري ٿو، جيڪو گهٽ نمائندگي ڪندڙ استعمال ڪندڙن لاءِ غير منصفانه يا غلط نتيجا ڏئي سگهي ٿو.
  • رازداري ۽ رضامندي جو خطرو: خاص طور تي چيٽس، آواز، صحت جي سار سنڀال، ۽ مالي ڊيٽا سان - جتي حساس معلومات ظاهر ٿي سگهي ٿي.
  • اصليت ۽ لائسنسنگ جي غير يقيني صورتحال: ٽيمون ڊيٽا گڏ ڪن ٿيون جيڪي اهي قانوني طور تي ٻيهر استعمال، شيئر، يا پيماني تي استعمال نٿا ڪري سگهن.
  • پيماني ۽ ٽائم لائن دٻاءُ: پائلٽ ڪامياب ٿين ٿا، پوءِ جڏهن حجم وڌي ٿو ۽ QA برقرار نه رهي سگهي ٿو ته معيار گهٽجي وڃي ٿو.
  • گم ٿيل موٽ جو دائرو: پيداوار جي نگراني کان سواءِ، ڊيٽاسيٽ حقيقت سان ملائڻ بند ڪري ٿو (نئون ارادو، نئين پاليسيون، نوان ايج ڪيس).

ڊيٽا گڏ ڪرڻ جا فائدا

ھن مسئلي جو ھڪڙو قابل اعتماد حل آھي ۽ توھان جي AI ماڊلز لاءِ تربيتي ڊيٽا حاصل ڪرڻ جا بھتر ۽ گھٽ قيمتي طريقا آھن. اسان انهن کي سڏين ٿا ٽريننگ ڊيٽا سروس فراهم ڪندڙ يا ڊيٽا وينڊرز.

اهي شيپ جهڙا ڪاروبار آهن جيڪي توهان جي منفرد ضرورتن ۽ گهرجن جي بنياد تي اعليٰ معيار جا ڊيٽا سيٽ پهچائڻ ۾ ماهر آهن. اهي ڊيٽا گڏ ڪرڻ ۾ توهان کي درپيش سڀني پريشانين کي ختم ڪن ٿا جهڙوڪ لاڳاپيل ڊيٽا سيٽن کي سورس ڪرڻ، انهن کي صاف ڪرڻ، مرتب ڪرڻ ۽ انهن کي تشريح ڪرڻ ۽ گهڻو ڪجهه، ۽ توهان کي صرف توهان جي AI ماڊلز ۽ الگورتھم کي بهتر ڪرڻ تي ڌيان ڏيڻ جي اجازت ڏين ٿا. ڊيٽا وينڊرز سان تعاون ڪندي، توهان انهن شين تي ڌيان ڏيو ٿا جيڪي اهم آهن ۽ انهن تي جن تي توهان جو ڪنٽرول آهي.

ان کان علاوه، توهان مفت ۽ اندروني وسيلن مان ڊيٽا سيٽ حاصل ڪرڻ سان لاڳاپيل سڀني پريشانين کي به ختم ڪري ڇڏيندا. توهان کي اينڊ-ٽو-اينڊ ڊيٽا فراهم ڪندڙ جي فائدن جي بهتر سمجھ ڏيڻ لاءِ، هتي هڪ مختصر فهرست آهي:

جڏهن ڊيٽا گڏ ڪرڻ صحيح طريقي سان ڪيو ويندو آهي، ته نتيجو ماڊل ميٽرڪس کان ٻاهر ظاهر ٿيندو آهي:

  • ماڊل جي اعتبار ۾ واڌارو: پيداوار ۾ گهٽ تعجب ۽ بهتر عام ڪرڻ.
  • تيز ورجائي چڪر: صفائي ۽ ٻيهر ليبلنگ ۾ گهٽ ڪم.
  • وڌيڪ قابل اعتماد LLM ايپس: بهتر گرائونڊنگ، گهٽ وهمي خيال، محفوظ جواب.
  • گھٽ ڊگهي مدت جي قيمت: معيار جي شروعات مهانگي ڊائون اسٽريم فڪسس کي روڪي ٿي.
  • بهتر تعميل واري پوزيشن: واضح دستاويز، آڊٽ جا رستا، ۽ ڪنٽرول ٿيل رسائي.


عمل ۾ AI ڊيٽا گڏ ڪرڻ جون حقيقي دنيا جون مثالون

اي آءِ ڊيٽا گڏ ڪرڻ جون حقيقي دنيا جون مثالون عمل ۾

مثال 1: ڪسٽمر سپورٽ ايل ايل ايم چيٽ بوٽ (آر اي جي + ايويوليشن)

  • مقصد: ٽڪيٽ جي مقدار کي گھٽايو ۽ سيلف سروس ريزوليوشن کي بهتر بڻايو.
  • ڊيٽا: ترتيب ڏنل مدد مرڪز جا مضمون، پراڊڪٽ دستاويز، ۽ گمنام حل ٿيل ٽڪيٽون.
  • بريفنگ ڏيندي: آر اي جي معيار کي ماپڻ لاءِ هڪ منظم حاصل ڪرڻ واري تشخيص جو سيٽ (صارف جو سوال → صحيح ذريعو دستاويز).
  • چرچو: اندروني دستاويزن کي وينڊر جي مدد سان تشريح سان گڏ ڪيو ويو ته جيئن ارادن کي ليبل ڪري سگهجي، سوالن کي جوابن سان ميپ ڪري سگهجي، ۽ حاصل ڪرڻ جي مطابقت جو جائزو وٺي سگهجي.
  • نتيجو وڌيڪ بنيادي جواب، گهٽتائي واڌ، ۽ گراهڪ جي اطمينان ۾ ماپي سگهارا.

مثال 2: وائيس اسسٽنٽ لاءِ اسپيچ AI

  • مقصد: مارڪيٽن، تلفظن، ۽ ماحول ۾ تقرير جي سڃاڻپ کي بهتر بڻايو.
  • ڊيٽا: مختلف اسپيڪرن، ماحول (خاموش گهر، مصروف گهٽيون، ڪارون)، ۽ ڊوائيسز مان هزارين ڪلاڪن جي تقرير.
  • بريفنگ ڏيندي: لہجے ۽ ٻولي جي ڪوريج جا منصوبا، معياري ٽرانسڪرپشن جا قاعدا، ۽ اسپيڪر/مقامي ميٽا ڊيٽا.
  • چرچو: عالمي سطح تي شرڪت ڪندڙن کي ڀرتي ڪرڻ، اسڪرپٽ ٿيل ۽ غير اسڪرپٽ ٿيل حڪمن کي رڪارڊ ڪرڻ، ۽ مڪمل طور تي نقل ٿيل، تشريح ٿيل، ۽ معيار جي جانچ ٿيل ڪارپورا پهچائڻ لاءِ تقرير ڊيٽا فراهم ڪندڙ سان ڀائيواري ڪئي.
  • نتيجا: حقيقي دنيا جي حالتن ۾ وڌيڪ سڃاڻپ جي درستگي ۽ غير معياري تلفظ وارن استعمال ڪندڙن لاءِ بهتر ڪارڪردگي.

مثال 3: هيلٿ ڪيئر اين ايل پي (پرائيويسي-پهريون)

  • مقصد: ڪلينڪل فيصلي سازي جي حمايت لاءِ غير منظم نوٽس مان ڪلينڪل تصورات ڪڍو.
  • ڊيٽا: سڃاڻپ نه ٿيل ڪلينڪل نوٽس ۽ رپورٽون، حالتن، دوائن، طريقيڪار، ۽ ليبارٽري قدرن لاءِ SME-نظرثاني ٿيل ليبلن سان مالا مال.
  • بريفنگ ڏيندي: سخت رسائي ڪنٽرول، انڪرپشن، ۽ آڊٽ لاگ HIPAA ۽ اسپتال جي پاليسين سان مطابقت رکن ٿا.
  • چرچو: سڃاڻپ جي خاتمي، اصطلاحن جي نقشي سازي، ۽ ڊومين ماهر تشريح کي سنڀالڻ لاءِ هڪ خاص صحت جي سار سنڀال ڊيٽا وينڊر استعمال ڪيو، اسپتال جي آئي ٽي ۽ ڪلينڪل عملي تي بار گهٽائڻ.
  • نتيجا: محفوظ ماڊل اعليٰ معيار جي ڪلينڪل سگنل سان، PHI کي ظاهر ڪرڻ يا تعميل سان سمجهوتو ڪرڻ کان سواءِ استعمال ڪيا ويا.

مثال 4: پيداوار ۾ ڪمپيوٽر ويزن

  • مقصد: پيداوار جي لائينن ۾ پاڻمرادو خرابين کي ڳوليو.
  • ڊيٽا: مختلف شفٽن، روشني جي حالتن، ڪئميرا اينگلز، ۽ پراڊڪٽ جي مختلف قسمن ۾ ڪارخانن جون تصويرون ۽ وڊيوز.
  • بريفنگ ڏيندي: خرابين جي قسمن لاءِ هڪ واضح آنٽولوجي ۽ QA ۽ ماڊل تشخيص لاءِ هڪ سون جو سيٽ.
  • چرچو: "عام" ۽ "خراب" شين تي ڌيان ڏيندي، متنوع بصري ڊيٽا گڏ ڪئي ۽ تشريح ڪئي، جنهن ۾ نادر پر نازڪ فالٽ جا قسم شامل آهن.
  • نتيجا: خرابي جي ڳولا ۾ گهٽ غلط مثبت ۽ غلط منفي، وڌيڪ قابل اعتماد خودڪار کي فعال ڪرڻ ۽ دستي معائني جي ڪوشش کي گھٽائڻ.

اي آءِ ڊيٽا ڪليڪشن وينڊرز جو جائزو ڪيئن وٺجي
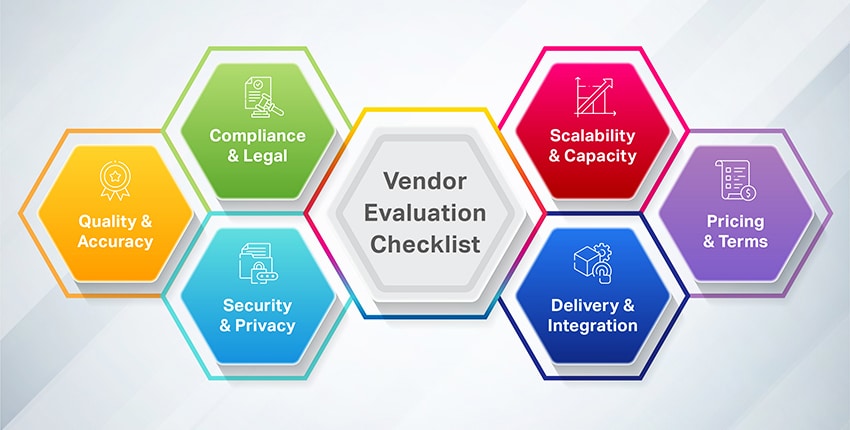
وڪرو ڪندڙ جي تشخيص جي چيڪ لسٽ

وڪرو ڪندڙ جي تشخيص جي چيڪ لسٽ

وينڊر جي جائزي دوران هي چيڪ لسٽ استعمال ڪريو:

معيار ۽ درستگي

  • دستاويزي معيار جي ضمانت جو عمل (گهڻن سطحن جو جائزو، خودڪار چڪاس)
  • انٽر اينوٽيٽر معاهدي جي ميٽرڪس موجود آهن
  • غلطي جي اصلاح ۽ موٽ ڏيڻ واري لوپ جا عمل
  • وابستگي کان اڳ نموني ڊيٽا جو جائزو

تعميل ۽ قانوني

  • ڊيٽا جي اصليت جي دستاويز کي صاف ڪريو
  • ڊيٽا جي مضمونن لاءِ رضامندي جا طريقا
  • GDPR، CCPA، ۽ لاڳاپيل علائقائي تعميل
  • ڊيٽا لائسنسنگ جون شرطون جيڪي توهان جي ارادي استعمال کي ڍڪينديون آهن
  • ڊيٽا IP مسئلن لاءِ معاوضي جون شقون

حفاظت ۽ رازداري

  • ايس او سي 2 ٽائپ II سرٽيفڪيشن (يا برابر)
  • ڊيٽا انڪرپشن آرام ۽ ٽرانزٽ ۾
  • رسائي ڪنٽرول ۽ آڊٽ لاگنگ
  • سڃاڻپ ختم ڪرڻ ۽ PII سنڀالڻ جا طريقا
  • ڊيٽا برقرار رکڻ ۽ ختم ڪرڻ جون پاليسيون

اسڪيليبلٽي ۽ گنجائش

  • توهان جي گهربل پيماني تي ثابت ٿيل ٽريڪ رڪارڊ
  • وقت جي لحاظ کان حساس منصوبن لاءِ گنجائش وڌائڻ
  • گھڻ-ٻوليون ۽ گھڻ-علائقائي صلاحيتون
  • توهان جي ٽارگيٽ ڊومينز ۾ افرادي قوت جي کوٽائي

پهچائڻ ۽ انضمام

  • API رسائي يا خودڪار پهچائڻ جا اختيار
  • توهان جي ايم ايل پائپ لائن سان مطابقت (فارميٽ، اسڪيما)
  • اصلاحي طريقيڪار سان SLA صاف ڪريو
  • شفاف منصوبي جو انتظام ۽ مواصلات

قيمت ۽ شرطون

  • شفاف قيمت جو ماڊل (في يونٽ، في ڪلاڪ، منصوبي تي ٻڌل)
  • نظرثاني، فارميٽ تبديلين، يا جلدي پهچائڻ لاءِ ڪا به لڪيل فيس ناهي.
  • لچڪدار معاهدي جون شرطون (پائلٽ آپشن، اسڪيلبل وابستگيون)
  • پهچائڻ وارن شين جي واضح ملڪيت

وينڊر اسڪورنگ روبرڪ

وينڊرز کي منظم طريقي سان ڀيٽڻ لاءِ هن ٽيمپليٽ کي استعمال ڪريو:

معيار وزن وينڊر اي (1-5) وينڊر بي (1-5) وينڊر سي (1-5)
معيار جي ضمانت جو عمل 20٪
تعميل ۽ اصليت 20٪
سيڪيورٽي سرٽيفڪيٽ 15٪
اسڪيليبلٽي ۽ گنجائش 15٪
ڊومين ماهر 10٪
قيمت جي شفافيت 10٪
پهچائڻ ۽ انضمام 10٪
ڪل وزني 100٪

اسڪورنگ گائيڊ:

5 = ضرورتن کان وڌيڪ، واضح صنعت جي قيادت؛

4 = مضبوط ثبوتن سان مڪمل طور تي گهرجن کي پورو ڪري ٿو؛

3 = گهرجن کي مناسب طور تي پورو ڪري ٿو؛

2 = جزوي طور تي گهرجن کي پورو ڪري ٿو، خالن جي سڃاڻپ ڪئي وئي آهي؛

1 = گهرجن کي پورو نٿو ڪري.

قيمت پڇڻ کان اڳ معيار جي تعريف ڪريو 

تشريح ۾ معيار هڪ نمبر ناهي. ليبل ڪلاس جي لحاظ کان ٽارگيٽ انٽر اينوٽيٽر معاهدي جي وضاحت ڪريو، اختلافن لاءِ فيصلي جو عمل، سون جي معيار جو سيٽ ۽ ڪير ان کي ٺاهيندو آهي، QA نموني جي شرح، جائزو وٺندڙ سند جي گهرج جتي ڪم کي ڊومين جي ماهر جي ضرورت آهي، ۽ جڏهن بيچ ناڪام ٿئي ٿي ته اصلاحي پاليسي. هڪ وڪرو ڪندڙ جيڪو انهن جي وضاحت کان اڳ قيمت جو حوالو ڏئي رهيو آهي اهو هڪ مختلف منصوبي لاءِ اقتباس ڪري رهيو آهي جيڪو توهان هلائيندا.

عام خريد ڪندڙ سوال (ريڊٽ، ڪوورا، ۽ انٽرپرائز آر ايف پي ڪالن کان)

اهي سوال انڊسٽري فورمز ۽ انٽرپرائز پروڪيورمينٽ بحثن مان عام موضوعن کي ظاهر ڪن ٿا.

"AI ٽريننگ ڊيٽا جي قيمت ڪيتري آهي؟"

قيمت ڊيٽا جي قسم، معيار جي سطح، ۽ پيماني جي لحاظ کان ڊرامائي طور تي مختلف آهي. سادي ليبلنگ جا ڪم في يونٽ 0.02-0.10 ڊالر تائين هلي سگهن ٿا؛ پيچيده تشريح (طبي، قانوني) في يونٽ 1-5 ڊالر کان وڌيڪ ٿي سگهي ٿي؛ ٽرانسڪرپشن سان تقرير ڊيٽا اڪثر ڪري في آڊيو ڪلاڪ 5-30 ڊالر تائين هلي ٿي. هميشه آل ان قيمت جي درخواست ڪريو جنهن ۾ QA، نظرثانيون، ۽ پهچائڻ جي قيمت شامل هجي.

"مون کي ڪيئن خبر پوي ته ڪنهن وينڊر جو ڊيٽا اصل ۾ 'صاف' ۽ قانوني طور تي حاصل ڪيل آهي؟"

اصلي دستاويز، لائسنس جي شرطن، ۽ رضامندي جي رڪارڊ جي درخواست ڪريو. خاص طور تي پڇو: "هن ڊيٽاسيٽ لاءِ، ذريعو مواد ڪٿان آيو، ۽ اسان کي ماڊل ٽريننگ لاءِ ان کي استعمال ڪرڻ جا ڪهڙا حق آهن؟" معزز وينڊرز هن جو جواب قطعي طور تي ڏئي سگهن ٿا.

"ڇا مصنوعي ڊيٽا ڪافي سٺو آهي، يا مون کي حقيقي ڊيٽا جي ضرورت آهي؟"

مصنوعي ڊيٽا واڌ، ايج ڪيسز، ۽ رازداري جي لحاظ کان حساس منظرنامي لاءِ قيمتي آهي. اهو عام طور تي بنيادي تربيتي ذريعو جي طور تي ڪافي ناهي - خاص طور تي انهن ڪمن لاءِ جن کي ثقافتي نزاڪت، لساني تنوع، يا حقيقي دنيا جي ايج ڪيس ڪوريج جي ضرورت آهي. هڪ مرکب استعمال ڪريو ۽ تناسب ڄاڻو.

"10,000 يونٽن جي تشريح واري منصوبي لاءِ هڪ مناسب ٽرن اراؤنڊ وقت ڇا آهي؟"

ڪيليبريشن سان گڏ معياري تشريح جي ڪمن لاءِ، 2-4 هفتا توقع ڪريو. پيچيده ڊومينز يا خاص ڪمن ۾ 4-8 هفتا لڳي سگهن ٿا. جلدي پهچائڻ اڪثر ممڪن آهي پر عام طور تي قيمت 25-50٪ وڌائي ٿو.

"معاهدي تي دستخط ڪرڻ کان اڳ مان معيار جو جائزو ڪيئن وٺان؟"

ادا ڪيل پائلٽ تي اصرار ڪريو. هڪ وينڊر جيڪو پائلٽ جي مصروفيت ڪرڻ لاءِ تيار ناهي (جيتوڻيڪ هڪ ننڍڙو به) اهو هڪ خطرو آهي. پائلٽ دوران، پنهنجو معيار جو جائزو لاڳو ڪريو - صرف وينڊر جي رپورٽ ڪيل ميٽرڪس تي ڀروسو نه ڪريو.

"ڪهڙا تعميل سرٽيفڪيشن سڀ کان وڌيڪ اهم آهن؟"

SOC 2 ٽائپ II انٽرپرائز ڊيٽا هينڊلنگ لاءِ بنيادي بنياد آهي. صحت جي سار سنڀال لاءِ، HIPAA BAAs بابت پڇو. EU آپريشنز لاءِ، دستاويزي DPA عملن سان GDPR جي تعميل جي تصديق ڪريو. ISO 27001 هڪ مثبت سگنل آهي پر عالمي طور تي گهربل ناهي.

"ڇا مان انٽرپرائز ايل ايل ايم ٽريننگ لاءِ ڪراؤڊ سورسڊ ڊيٽا استعمال ڪري سگهان ٿو؟"

ڪراؤڊ سورس ٿيل ڊيٽا عام مقصد جي ڪمن لاءِ ڪم ڪري سگھي ٿو پر اڪثر انٽرپرائز ايپليڪيشنن لاءِ گهربل مستقل مزاجي ۽ ڊومين جي مهارت جي کوٽ هوندي آهي. خاص ڊومينز (قانوني، طبي، مالي) لاءِ، وقف ماهر تشريح ڪندڙ عام طور تي ڪراؤڊ سورس ٿيل طريقن کان بهتر ڪارڪردگي ڏيکاريندا آهن.

"جيڪڏهن منهنجي ڊيٽا کي پروجيڪٽ جي وچ ۾ تبديل ڪرڻ جي ضرورت هجي ته ڇا ٿيندو؟"

دائري ۾ تبديلي جي طريقيڪار تي اڳواٽ ئي ڳالهه ٻولهه ڪريو. سمجھو ته تبديليون قيمت، ٽائم لائن، ۽ معيار جي بنيادي بنيادن کي ڪيئن متاثر ڪن ٿيون. ايم ايل منصوبن سان تجربيڪار وينڊرز ٻيهر ٿيڻ جي اميد رکن ٿا - سخت تبديلي جي آرڊر جا عمل لچڪ جي نشاندهي ڪري سگهن ٿا.

"مان تربيتي ڊيٽا ۾ PII کي ڪيئن سنڀاليندس؟"

انهن وينڊرز سان ڪم ڪريو جن سڃاڻپ جي عمل کي ختم ڪيو آهي ۽ پنهنجي طريقي جي دستاويز مهيا ڪري سگهن ٿا. حساس ڊيٽا لاءِ، ڊيٽا جي منتقلي کي گھٽ ڪرڻ لاءِ آن پريمائس يا وي پي سي ڊيپلائيمينٽ آپشن تي بحث ڪريو.

"ڊيٽا گڏ ڪرڻ ۽ ڊيٽا تشريح ۾ ڇا فرق آهي؟"

ڊيٽا گڏ ڪرڻ خام ڊيٽا حاصل ڪرڻ يا ٺاهڻ آهي (تقرير رڪارڊ ڪرڻ، ٽيڪسٽ نموني گڏ ڪرڻ، تصويرون پڪڙڻ). ڊيٽا تشريح موجوده ڊيٽا کي ليبل ڪرڻ آهي (آڊيو ٽرانسڪرپشن، جذبات کي ٽيگ ڪرڻ، باؤنڊنگ باڪس ٺاهڻ). گھڻن منصوبن کي ٻنهي جي ضرورت هوندي آهي، ڪڏهن ڪڏهن مختلف وينڊرز کان.

شيپ توهان جي اي آءِ ڊيٽا جي مهارت ڪيئن پهچائي ٿو

شيپ ڊيٽا گڏ ڪرڻ جي پيچيدگي کي ختم ڪري ٿو تنهنڪري توهان ماڊل جدت تي ڌيان ڏيو. هتي اسان جي ثابت ٿيل مهارت آهي:

عالمي پيماني تي + رفتار

  • 70+ ملڪن ۾ متنوع، وڏي مقدار جي ڊيٽاسيٽس لاءِ 50,000+ حصو وٺندڙ
  • تيزيءَ سان 150+ ٻولين ۾ ٽيڪسٽ، آڊيو، تصوير، وڊيو گڏ ڪريو.
  • حقيقي وقت جي ڪم جي ورڇ ۽ معيار جي ڪنٽرول لاءِ ملڪيت واري شيپ ڪلائوڊ ايپ

آخر کان آخر تائين ڪم فلو

گهرجون → گڏ ڪرڻ → صفائي → تشريح → QA → پهچائڻ

صنعت جي لحاظ کان ڊومين ماهر

انڊسٽري شيپ ماهر
صحت جي سار سنڀار سڃاڻپ نه ٿيل ڪلينڪل ڊيٽا (31 خاصيتون)، HIPAA- مطابق، SME- جائزو ورتو ويو
گفتگو ڪندڙ AI گھڻن تلفظن واري تقرير، قدرتي تقريرون، جذبات جي ٽيگنگ
ڪمپيوٽر ويڊيو شئي جي ڳولا، ڀاڱيداري، ڪنڊ ڪيس منظرنامو
جين اي آءِ / ايل ايل ايم آر ايل ايڇ ايف ڊيٽاسيٽس، دليلن جون زنجيرون، حفاظتي معيار

ٽيمون شيپ ڇو چونڊين ٿيون

✅ پائلٽ-پهريون طريقو - اسڪيلنگ کان اڳ نتيجا ثابت ڪريو

✅ نموني ڊيٽاسيٽ 7 ڏينهن ۾ پهچايا ويا - اسان کي خطري کان سواءِ آزمايو

✅ 95%+ انٽر اينوٽيٽر معاهدو - ماپيل، واعدو نه ڪيل

✅ عالمي تنوع - ڊيزائن جي لحاظ کان متوازن نمائندگي

✅ بلٽ ان تعميل - GDPR، HIPAA، CCPA ڪليڪشن کان ڊليوري تائين

✅ اسڪيلبل قيمت - ٻيهر ڳالهين کان سواءِ پيداوار لاءِ پائلٽ

حقيقي نتيجا

  • وائيس اي آءِ: تلفظن/لهجن ۾ 25 سيڪڙو بهتر سڃاڻپ
  • صحت جي سار سنڀال اين ايل پي: ڪلينڪل ماڊلز صفر پي ايڇ آءِ جي نمائش سان ٽي ڀيرا تيز تربيت يافته آهن
  • آر اي جي سسٽم: تيار ڪيل گرائونڊنگ ڊيٽا سان 40٪ بحالي بهتري

ٿڪل

ڇا توهان بهترين AI ٽريننگ ڊيٽا فراهم ڪندڙ ڳولڻ لاءِ هڪ شارٽ ڪٽ ڄاڻڻ چاهيو ٿا ؟ اسان سان رابطو ڪريو. انهن سڀني ٿڪائيندڙ عملن کي ڇڏي ڏيو ۽ پنهنجي AI ماڊلز لاءِ اعليٰ معيار ۽ صحيح ڊيٽاسيٽس لاءِ اسان سان ڪم ڪريو.

اسان انهن سڀني خانن کي چيڪ ڪريون ٿا جن تي اسان هينئر تائين بحث ڪيو آهي. هن خلا ۾ هڪ پائيدار هجڻ جي ڪري، اسان ڄاڻون ٿا ته اهو ڇا وٺندو آهي هڪ AI ماڊل ٺاهڻ ۽ ماپ ڪرڻ ۽ ڪئين ڊيٽا هر شيء جي مرڪز ۾ آهي.

اسان اهو پڻ سمجهون ٿا ته خريد ڪندڙ جي گائيڊ مختلف طريقن سان وسيع ۽ وسيلا هئي. AI ٽريننگ پيچيده آهي جيئن ته اها آهي پر انهن تجويزن ۽ سفارشن سان، توهان انهن کي گهٽ تڪليف ڏئي سگهو ٿا. آخر ۾، توهان جي پيداوار واحد عنصر آهي جيڪو آخرڪار هن سڀني مان فائدو وٺندو.

اچو ت ڳالھايون

  • هي ميدان جي تصديق جي مقصد لاء آهي ۽ اڻڄاتل رهجي وڃي.
  • رجسٽر ڪرڻ سان، مان شيپ سان متفق آهيان ذاتي زندگي جي پاليسي ۽ سروس جي شرطن ۽ شيپ کان B2B مارڪيٽنگ ڪميونيڪيشن حاصل ڪرڻ لاءِ منهنجي رضامندي فراهم ڪريو.

اڪثر پڇيا ويا سوال (سوالات)

AI ڊيٽا گڏ ڪرڻ مشين لرننگ ماڊلز کي تربيت ڏيڻ لاءِ استعمال ٿيندڙ ڊيٽاسيٽس کي سورس ڪرڻ، ٺاهڻ ۽ ڪيوريٽ ڪرڻ جو عمل آهي. LLMs ۽ چيٽ بوٽس لاءِ، ان ۾ گفتگو لاگ، هدايت-جواب جوڙو، ترجيح ڊيٽا، ۽ ڊومين-مخصوص ٽيڪسٽ ڪارپورا شامل آهن.

جديد ايل ايل ايم پنهنجي تربيتي ڊيٽا مان نمونا سکندا آهن. گهٽ معيار وارو ڊيٽا - غلطين، تعصبن، يا غير مطابقتن سان - سڌو سنئون ماڊل جي ڪارڪردگي کي خراب ڪري ٿو. هڪ ننڍو، اعليٰ معيار وارو ڊيٽا سيٽ اڪثر ڪري وڏي، شور واري ڊيٽا سيٽ کان بهتر ڪارڪردگي ڏيکاري ٿو.

آر ايل ايڇ ايف (انساني راءِ کان مضبوطي جي سکيا) ڊيٽا انساني ترجيحن جي تشريح تي مشتمل آهي جيڪي ماڊل آئوٽ پُٽ کي گهربل رويي سان ترتيب ڏيڻ ۾ مدد ڪن ٿيون. تشريح ڪندڙ ماڊل جوابن جو مقابلو ڪن ٿا ۽ ظاهر ڪن ٿا ته ڪهڙو بهتر آهي، ترتيب لاءِ تربيتي سگنل ٺاهيندا آهن.

مصنوعي ڊيٽا حقيقي ڊيٽا کي وڌائڻ، ايج ڪيس پيدا ڪرڻ، ۽ رازداري کي محفوظ ڪرڻ جا متبادل ٺاهڻ لاءِ سٺو ڪم ڪري ٿو. ان کي پنهنجي بنيادي تربيتي ذريعو طور استعمال ڪرڻ کان پاسو ڪريو، خاص طور تي انهن ڪمن لاءِ جن کي ثقافتي نزاڪت يا حقيقي دنيا جي تنوع جي ضرورت آهي.

ڊيٽا جي اصليت هڪ ڊيٽا سيٽ جي دستاويزي زنجير آهي - اهو ڪٿان آيو، اهو ڪيئن گڏ ڪيو ويو، ڪهڙي رضامندي حاصل ڪئي وئي، ۽ ڪهڙا لائسنس ان جي استعمال کي منظم ڪن ٿا. ريگيوليٽري تعميل لاءِ اصليت جي ضرورت وڌي رهي آهي.

وقت جي حد دائري جي لحاظ کان مختلف هوندي آهي. هڪ پائلٽ (500-2,000 يونٽ) عام طور تي 2-4 هفتا وٺندو آهي. پيداواري منصوبا (10,000-100,000+ يونٽ) 1-3 مهينا وٺي سگهن ٿا. پيچيده ڊومين يا گهڻ لساني منصوبا اضافي وقت شامل ڪن ٿا.

SOC 2 ٽائپ II انٽرپرائز ڊيٽا هينڊلنگ لاءِ معيار آهي. صحت جي سار سنڀال جي ايپليڪيشنن لاءِ HIPAA جي تعميل اهم آهي. EU سان لاڳاپيل ڊيٽا لاءِ GDPR جي تعميل گهربل آهي. ISO 27001 هڪ مثبت اضافي سگنل آهي.

اجازت ڏنل ڊيٽا واضح رضامندي يا مناسب لائسنس سان گڏ ڪئي ويندي آهي. ختم ٿيل ڊيٽا ويب سائيٽن تان ڪڍيو ويندو آهي، اڪثر ڪري اجازت کان سواءِ. قانوني ۽ شهرت جي خطري کي گهٽائڻ لاءِ اجازت ڏنل ڊيٽا جي ضرورت وڌي رهي آهي.

واضح قبوليت جي معيار سان هڪ ادا ڪيل پائلٽ هلائي. صرف وينڊر ميٽرڪس تي ڀروسو ڪرڻ بدران پنهنجي معيار جي جائزي جي عمل کي لاڳو ڪريو. خاص طور تي ايج ڪيسن ۽ مبهم مثالن جي جانچ ڪريو.

آر اي جي (ريٽريول-آگمينٽڊ جنريشن) تشخيصي ڊيٽا ۾ سوال-دستاويز-جواب جا ٽيپلٽ شامل آهن جيڪي جانچ ڪن ٿا ته ڇا ڪو سسٽم لاڳاپيل تناظر حاصل ڪري ٿو ۽ صحيح جواب پيدا ڪري ٿو. اهو آر اي جي درستگي کي ماپڻ ۽ بهتر ڪرڻ لاءِ ضروري آهي.

قيمت جي ماڊل ۾ في يونٽ (في تشريح، في تصوير)، في ڪلاڪ (آڊيو/وڊيو لاءِ)، ۽ پروجيڪٽ تي ٻڌل شامل آهن. سڀني ۾ قيمت جي درخواست ڪريو جنهن ۾ QA، نظرثانيون، ۽ ترسيل شامل آهن. قيمتون پيچيدگي ۽ گهربل ڊومين جي مهارت جي لحاظ کان وڏي پيماني تي مختلف آهن.

شامل ڪريو: منصوبي جي دائري ۽ ڊيٽا جا قسم، معيار جون گهرجون ۽ قبوليت جا معيار، تعميل جون گهرجون، وقت جي پابنديون، حجم جو اندازو، فارميٽ جون وضاحتون، ۽ وينڊر جي چونڊ لاءِ تشخيصي معيار.

ها. وڪرو ڪندڙ ڊيٽا جي افزودگي، ٻيهر تشريح، ۽ معيار جي بهتري جون خدمتون پيش ڪن ٿا. توهان موجوده اصطلاحن ۽ معلومات کي ظاهر ڪرڻ لاءِ ايج ڪيس، بيلنس ڊيموگرافڪ نمائندگي، يا ڊيٽا کي اپڊيٽ پڻ ڪري سگهو ٿا.